
-
วิเคราะห์ข้อเสนอและช่วงราคาจริงจากร้านค้า Shopeeประเมินความคุ้มค่าตามช่วงราคาต่ำสุด-สูงสุดจริงจากร้านค้าทางการ บันทึกข้อมูล ณ วันที่สำรวจ ไม่มีการสร้างเวลานับถอยหลังหลอกลวง (No Artificial Urgency) หรือคูปองที่ไม่มีอยู่จริงวิเคราะห์ข้อเสนอและช่วงราคาจริงจากร้านค้า Shopeeประเมินความคุ้มค่าตามช่วงราคาต่ำสุด-สูงสุดจริงจากร้านค้าทางการ บันทึกข้อมูล ณ วันที่สำรวจ ไม่มีการสร้างเวลานับถอยหลังหลอกลวง (No Artificial Urgency) หรือคูปองที่ไม่มีอยู่จริง0 Comments 0 Shares 564 Views 0 Reviews
-
วิเคราะห์ข้อเสนอและช่วงราคาจริงจากร้านค้า Shopeeประเมินความคุ้มค่าตามช่วงราคาต่ำสุด-สูงสุดจริง บันทึกข้อมูล ณ วันที่สำรวจ (2026-09-18 00:22:58) ปราศจากการตั้งเวลานับถอยหลังหลอกลวงวิเคราะห์ข้อเสนอและช่วงราคาจริงจากร้านค้า Shopeeประเมินความคุ้มค่าตามช่วงราคาต่ำสุด-สูงสุดจริง บันทึกข้อมูล ณ วันที่สำรวจ (2026-09-18 00:22:58) ปราศจากการตั้งเวลานับถอยหลังหลอกลวง0 Comments 0 Shares 564 Views 0 Reviews
-
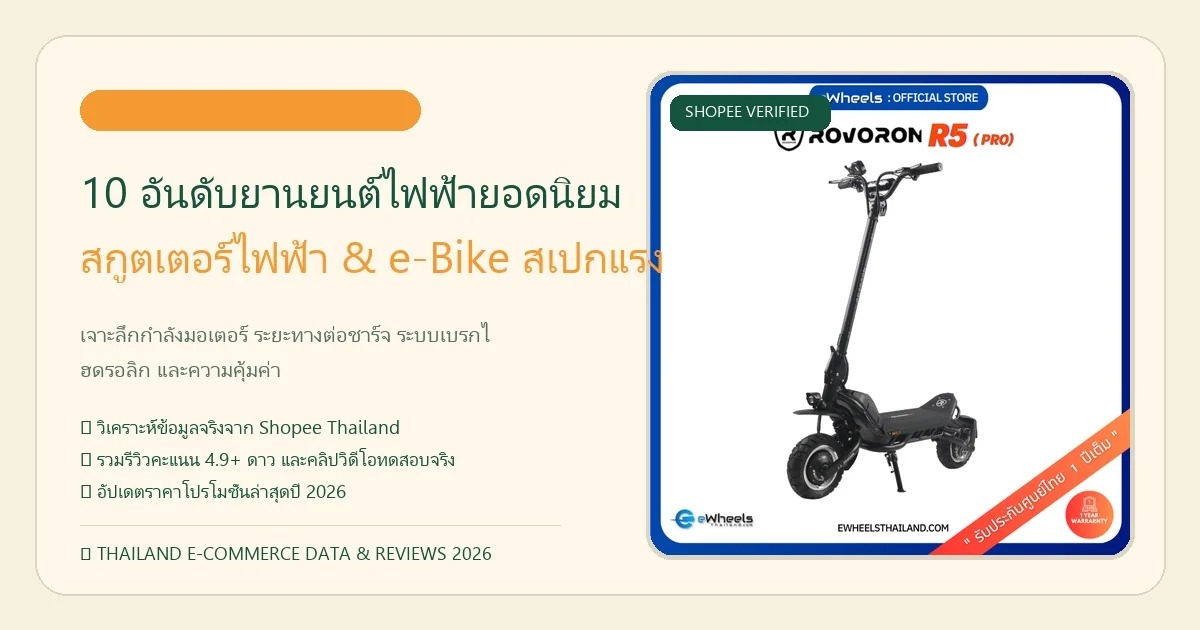
เช็กราคาโปรโมชั่น ค่าใช้จ่ายต่อกิโลเมตร และสิทธิประโยชน์ศูนย์ไทย 2026
คำนวณต้นทุนการใช้งานจริง ค่าชาร์จไฟฟ้าต่อ 100 กม. เทียบกับค่าน้ำมัน พร้อมเงื่อนไขการรับประกันศูนย์ไทย 1 ปีเต็มจากร้านค้าทางการบน Shopee
เช็กราคาโปรโมชั่น ค่าใช้จ่ายต่อกิโลเมตร และสิทธิประโยชน์ศูนย์ไทย 2026คำนวณต้นทุนการใช้งานจริง ค่าชาร์จไฟฟ้าต่อ 100 กม. เทียบกับค่าน้ำมัน พร้อมเงื่อนไขการรับประกันศูนย์ไทย 1 ปีเต็มจากร้านค้าทางการบน Shopeehttps://ai-thai.com/_Make_www/002-byc-man/index4.php0 Comments 0 Shares 564 Views 0 Reviews -
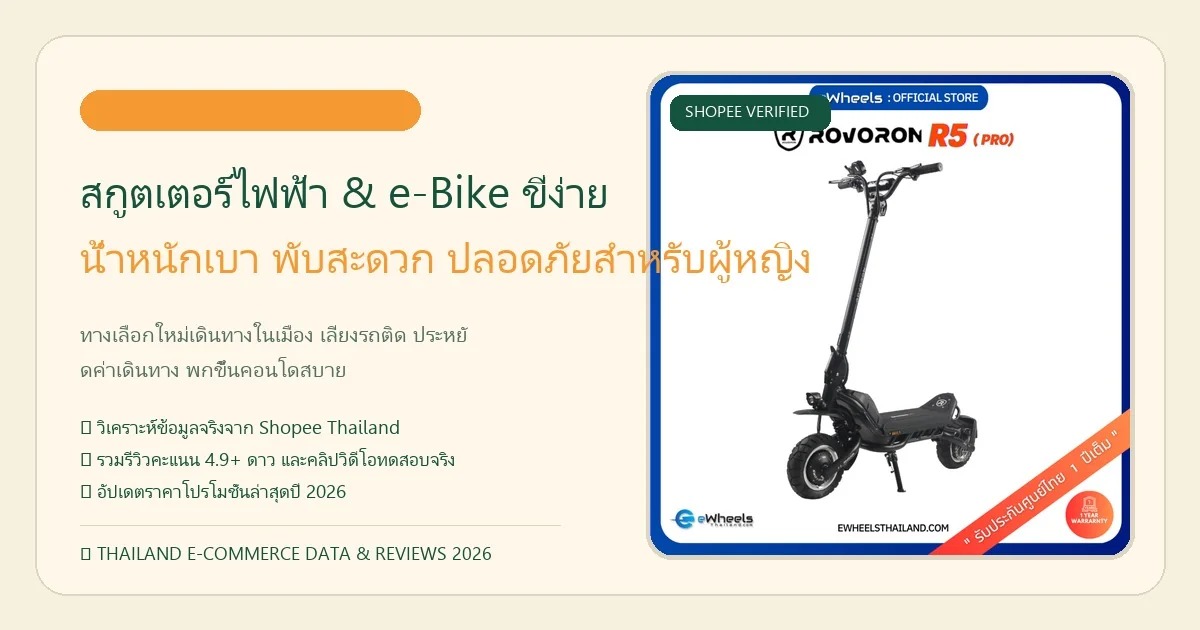
เช็กราคาโปรโมชั่น ประกันศูนย์ไทย 1 ปี และค่าชาร์จไฟสุดประหยัด 2026
คำนวณต้นทุนการเดินทางสำหรับผู้หญิง: ชาร์จไฟเต็มครั้งละไม่ถึง 10 บาท วิ่งได้หลายวัน ประหยัดเงินในกระเป๋าหลักพันต่อเดือน พร้อมเงื่อนไขรับประกันศูนย์ไทยแท้เช็กราคาโปรโมชั่น ประกันศูนย์ไทย 1 ปี และค่าชาร์จไฟสุดประหยัด 2026 คำนวณต้นทุนการเดินทางสำหรับผู้หญิง: ชาร์จไฟเต็มครั้งละไม่ถึง 10 บาท วิ่งได้หลายวัน ประหยัดเงินในกระเป๋าหลักพันต่อเดือน พร้อมเงื่อนไขรับประกันศูนย์ไทยแท้0 Comments 0 Shares 565 Views 0 Reviews -
ฝึกฝน AI ให้วาดภาพสีน้ำ ด้วย TRL และ OpenEnv
เคยเห็นภาพวาดสีน้ำสวยๆ ที่สร้างสรรค์โดย AI ไหมครับ? เมื่อไม่นานมานี้ ได้มีวิดีโอที่แสดงผลงานสีน้ำที่สร้างโดยโมเดลภาษา ซึ่งเขียนโค้ด JavaScript ผ่านไลบรารี p5.brush ที่ช่วยเพิ่มเครื่องมือวาดภาพธรรมชาติให้กับ p5.js วิดีโอนี้ได้รับความสนใจอย่างรวดเร็ว มียอดวิวสูงถึง 1.5 ล้านวิว!
เบื้องหลังความน่าทึ่งนี้ คือการฝึกฝนโมเดลให้สร้างสรรค์ผลงานศิลปะ โดยมีเป้าหมายที่จะทำให้การพัฒนา AI เป็นไปอย่างเปิดกว้างและเข้าถึงได้ ผ่านการใช้ Open Source และ Open Science บทความนี้จะพาไปทำความเข้าใจเบื้องหลังการสร้างสรรค์ผลงานดังกล่าว โดยใช้เครื่องมืออย่าง TRL (Transformer Reinforcement Learning) และ OpenEnv
แรงบันดาลใจจากศิลปะสู่โค้ด
ไอเดียตั้งต้นมาจากฝั่งศิลปะและการออกแบบ ที่ต้องการสร้างสรรค์ผลงานที่ดูเป็นธรรมชาติ ไม่สมบูรณ์แบบเหมือนภาพที่ AI สร้างขึ้นทั่วไป แต่ให้ความรู้สึกเหมือนภาพวาดด้วยมือ ซึ่งความไม่สมบูรณ์แบบนี้เองที่เป็นเสน่ห์ดึงดูดใจ ทำให้ผู้คนสนใจในผลงานที่แตกต่างนี้
โมเดล AI ไม่ได้เพียงแค่สร้างภาพ แต่เป็นการเขียนโปรแกรม JavaScript ประมาณ 150 บรรทัด เพื่อสั่งให้เกิดการวาดภาพนั้นๆ ผลลัพธ์ที่ได้คือ "โค้ด" ที่เราสามารถอ่าน ทำความเข้าใจ แก้ไข และรันใหม่ได้ การตัดสินใจในแต่ละฝีแปรงจะปรากฏให้เห็นอย่างชัดเจน และสไตล์ของภาพสีน้ำก็มาจากข้อจำกัดในการใช้เมธอดเพียง 10 อย่าง จากไลบรารี p5.brush เท่านั้น
TRL และ OpenEnv: เครื่องมือสู่การสร้างสรรค์
บทความนี้จะพาไปเจาะลึกถึงการนำ TRL และ OpenEnv มาใช้เพื่อจำลองแนวคิดนี้ให้เป็นจริง โดยทุกชิ้นส่วน ตั้งแต่ชุดข้อมูลอ้างอิง (reference pool dataset), สภาพแวดล้อม RL (RL environment), สคริปต์การฝึกฝน (training scripts) ไปจนถึงโมเดลที่ฝึกฝนแล้ว (trained models) ล้วนถูกเปิดเผยเป็น Open Source
กระบวนการทั้งหมดสามารถทำงานได้บน Hugging Face ตั้งแต่ต้นจนจบ:
- สภาพแวดล้อม RL และโมเดลประเมินผล (scorer model): จัดการผ่าน Hugging Face Spaces
- การเปรียบเทียบแบบคู่ (pairwise judge): ผ่าน Inference Providers
- สิ่งประดิษฐ์ทั้งหมด (artifacts): รวบรวมไว้บน Hugging Face Hub ในคอลเลกชันเดียว
เมื่อ Spaces ทั้งสองพร้อมใช้งาน การสร้างสรรค์ก็ง่ายเพียงแค่รันคำสั่งเดียว โดยการจำลองสภาพแวดล้อมและโมเดลประเมินผล ตั้งค่าตัวแปรสภาพแวดล้อมสำหรับการผสมผสานรางวัล (reward mix) แล้วเริ่มการทำงาน
การสร้างสภาพแวดล้อม RL ที่จำเป็น 🛠️
สภาพแวดล้อมนี้จะทำหน้าที่ห่อหุ้มทุกอย่างที่อยู่ระหว่างโมเดลและฟังก์ชันรางวัล (reward function) ซึ่งรวมถึง:
- ไลบรารี JavaScript สำหรับการวาดภาพ: p5.brush ซึ่งจำลองคุณสมบัติของสีน้ำ เช่น การไหลของเม็ดสี, พื้นผิวของกระดาษ, น้ำหนักของฝีแปรง
- System Prompt: กำหนดข้อจำกัดให้กับโมเดล
- Headless Chromium: ใช้สำหรับเรนเดอร์ภาพร่างแต่ละภาพ
- Gate: ตรวจสอบความถูกต้องและป้องกันการโกง
ไลบรารี p5.brush มีเมธอดถึง 47 อย่าง แต่ Prompt ที่ใช้จะจำกัดให้โมเดลใช้เพียง 10 อย่าง เช่น
scaleBrushes,noStroke,fill,fillBleed,circleเป็นต้น การจำกัดนี้ช่วยให้โมเดลสร้างภาพที่ดูเหมือนสีน้ำมากขึ้น โดยเฉพาะเมื่อใช้เมธอดfillBleedที่ควบคุมการไหลของหมึกPool: ฟังก์ชันรางวัลเพื่อรสชาติศิลปะ 🎨
Pool นี้ประกอบด้วยภาพวาดที่สร้างโดยโมเดล AI จำนวน 178 ภาพ ซึ่งแบ่งออกเป็น 2 ระดับตามความชอบส่วนตัวของผู้สร้างสรรค์ ได้แก่ "love" และ "okay" ภาพเหล่านี้สร้างขึ้นจากโมเดล Open Weight 4 ตัว โดยใช้ p5.brush sketch และอ้างอิงจากภาพถ่ายดอกชบาที่ได้รับอนุญาตให้ใช้งานได้อย่างเปิดเผย
โมเดล Vision จะให้ข้อเสนอแนะที่เป็นลายลักษณ์อักษรสำหรับแต่ละ sketch และผ่านการปรับปรุง 3 รอบ สุดท้าย ภาพที่เสร็จสมบูรณ์จะถูกให้คะแนนทีละภาพ และ 178 ภาพนี้คือภาพที่ผ่านเกณฑ์
สิ่งที่น่าสนใจคือ โมเดลจะเรียนรู้ที่จะเลียนแบบสิ่งที่อยู่ใน Pool หากเราเปลี่ยนชุดข้อมูล ฟังก์ชันรางวัลก็จะเปลี่ยนไปโดยอัตโนมัติโดยไม่ต้องแก้ไขโค้ดแม้แต่บรรทัดเดียว
การเปรียบเทียบโมเดลประเมินผล 📊
มีโมเดลประเมินผล 2 ตัวที่ทำงานแตกต่างกัน:
- HPSv3: เป็น Preference Model ขนาด 7B ที่ให้คะแนนว่าคนทั่วไปจะชอบภาพนั้นมากน้อยเพียงใด โดยฝึกฝนจากชุดข้อมูลการเลือกภาพจำนวนมาก
- Pairwise Judge (Qwen3-VL-30B-A3B-Instruct): เป็นโมเดล Vision ทั่วไปที่เปรียบเทียบภาพที่สร้างขึ้นกับภาพอ้างอิง 4 ภาพจาก Pool และให้คะแนนตามสัดส่วนการชนะการเปรียบเทียบ
ผู้สร้างสรรค์ได้ทดลองฝึกฝน 3 รัน โดยแตกต่างกันที่น้ำหนัก (weight) ที่แบ่งให้กับโมเดลประเมินผลทั้งสองตัว:
- hps-only: ใช้ HPSv3 เพียงอย่างเดียว เพื่อทดสอบว่าไปป์ไลน์สามารถเรียนรู้ได้หรือไม่
- hps + judge (w=0.5): ผสมผสาน HPSv3 และ Pairwise Judge ด้วยน้ำหนักเท่ากัน
- hps + judge (w=0.2): ผสมผสาน HPSv3 และ Pairwise Judge โดย Pairwise Judge มีน้ำหนักน้อยกว่า
ผลการทดลองแสดงให้เห็นว่า Pool ที่สร้างขึ้นด้วยมือสามารถชี้นำนโยบาย (policy) ของโมเดลได้
ข้อควรระวังในการฝึกฝน ⚠️
- การขาดภาพวาดที่มนุษย์สร้างสรรค์: Pool ที่ใช้ส่วนใหญ่เป็นภาพที่สร้างโดย AI ซึ่งเป็นข้อจำกัด เนื่องจากภาพวาดสีน้ำที่ใช้ p5.brush และมีโค้ดให้ศึกษาได้นั้นมีจำนวนจำกัด
- การปรับพารามิเตอร์ LoRA: การตั้งค่า
target_modulesสำหรับโมเดลประเภท Mixture of Experts (MoE) เช่น Qwen/Qwen3.5-35B-A3B ต้องได้รับการปรับอย่างระมัดระวัง เพื่อให้ Adapter สามารถฝึกฝนกับทุก Layer ที่เกี่ยวข้องได้
สรุป
การฝึกฝนโมเดล AI ให้วาดภาพสีน้ำด้วย TRL และ OpenEnv เป็นตัวอย่างที่น่าสนใจของการนำเทคนิค Reinforcement Learning มาใช้กับความชอบทางศิลปะ แสดงให้เห็นว่า AI สามารถเรียนรู้และสร้างสรรค์ผลงานที่มีสไตล์เฉพาะตัวได้ โดยอาศัยการออกแบบฟังก์ชันรางวัลที่เหมาะสม และการใช้เครื่องมือ Open Source ที่มีประสิทธิภาพ
#AIArt #Watercolour #TRL #OpenAI
ขอบคุณ แหล่งข้อมูล
https://huggingface.co/blog/train-to-paint-with-codeฝึกฝน AI ให้วาดภาพสีน้ำ ด้วย TRL และ OpenEnvเคยเห็นภาพวาดสีน้ำสวยๆ ที่สร้างสรรค์โดย AI ไหมครับ? เมื่อไม่นานมานี้ ได้มีวิดีโอที่แสดงผลงานสีน้ำที่สร้างโดยโมเดลภาษา ซึ่งเขียนโค้ด JavaScript ผ่านไลบรารี p5.brush ที่ช่วยเพิ่มเครื่องมือวาดภาพธรรมชาติให้กับ p5.js วิดีโอนี้ได้รับความสนใจอย่างรวดเร็ว มียอดวิวสูงถึง 1.5 ล้านวิว!เบื้องหลังความน่าทึ่งนี้ คือการฝึกฝนโมเดลให้สร้างสรรค์ผลงานศิลปะ โดยมีเป้าหมายที่จะทำให้การพัฒนา AI เป็นไปอย่างเปิดกว้างและเข้าถึงได้ ผ่านการใช้ Open Source และ Open Science บทความนี้จะพาไปทำความเข้าใจเบื้องหลังการสร้างสรรค์ผลงานดังกล่าว โดยใช้เครื่องมืออย่าง TRL (Transformer Reinforcement Learning) และ OpenEnvแรงบันดาลใจจากศิลปะสู่โค้ดไอเดียตั้งต้นมาจากฝั่งศิลปะและการออกแบบ ที่ต้องการสร้างสรรค์ผลงานที่ดูเป็นธรรมชาติ ไม่สมบูรณ์แบบเหมือนภาพที่ AI สร้างขึ้นทั่วไป แต่ให้ความรู้สึกเหมือนภาพวาดด้วยมือ ซึ่งความไม่สมบูรณ์แบบนี้เองที่เป็นเสน่ห์ดึงดูดใจ ทำให้ผู้คนสนใจในผลงานที่แตกต่างนี้โมเดล AI ไม่ได้เพียงแค่สร้างภาพ แต่เป็นการเขียนโปรแกรม JavaScript ประมาณ 150 บรรทัด เพื่อสั่งให้เกิดการวาดภาพนั้นๆ ผลลัพธ์ที่ได้คือ "โค้ด" ที่เราสามารถอ่าน ทำความเข้าใจ แก้ไข และรันใหม่ได้ การตัดสินใจในแต่ละฝีแปรงจะปรากฏให้เห็นอย่างชัดเจน และสไตล์ของภาพสีน้ำก็มาจากข้อจำกัดในการใช้เมธอดเพียง 10 อย่าง จากไลบรารี p5.brush เท่านั้นTRL และ OpenEnv: เครื่องมือสู่การสร้างสรรค์บทความนี้จะพาไปเจาะลึกถึงการนำ TRL และ OpenEnv มาใช้เพื่อจำลองแนวคิดนี้ให้เป็นจริง โดยทุกชิ้นส่วน ตั้งแต่ชุดข้อมูลอ้างอิง (reference pool dataset), สภาพแวดล้อม RL (RL environment), สคริปต์การฝึกฝน (training scripts) ไปจนถึงโมเดลที่ฝึกฝนแล้ว (trained models) ล้วนถูกเปิดเผยเป็น Open Sourceกระบวนการทั้งหมดสามารถทำงานได้บน Hugging Face ตั้งแต่ต้นจนจบ:สภาพแวดล้อม RL และโมเดลประเมินผล (scorer model): จัดการผ่าน Hugging Face Spacesการเปรียบเทียบแบบคู่ (pairwise judge): ผ่าน Inference Providersสิ่งประดิษฐ์ทั้งหมด (artifacts): รวบรวมไว้บน Hugging Face Hub ในคอลเลกชันเดียวเมื่อ Spaces ทั้งสองพร้อมใช้งาน การสร้างสรรค์ก็ง่ายเพียงแค่รันคำสั่งเดียว โดยการจำลองสภาพแวดล้อมและโมเดลประเมินผล ตั้งค่าตัวแปรสภาพแวดล้อมสำหรับการผสมผสานรางวัล (reward mix) แล้วเริ่มการทำงานการสร้างสภาพแวดล้อม RL ที่จำเป็น 🛠️สภาพแวดล้อมนี้จะทำหน้าที่ห่อหุ้มทุกอย่างที่อยู่ระหว่างโมเดลและฟังก์ชันรางวัล (reward function) ซึ่งรวมถึง:ไลบรารี JavaScript สำหรับการวาดภาพ: p5.brush ซึ่งจำลองคุณสมบัติของสีน้ำ เช่น การไหลของเม็ดสี, พื้นผิวของกระดาษ, น้ำหนักของฝีแปรงSystem Prompt: กำหนดข้อจำกัดให้กับโมเดลHeadless Chromium: ใช้สำหรับเรนเดอร์ภาพร่างแต่ละภาพGate: ตรวจสอบความถูกต้องและป้องกันการโกงไลบรารี p5.brush มีเมธอดถึง 47 อย่าง แต่ Prompt ที่ใช้จะจำกัดให้โมเดลใช้เพียง 10 อย่าง เช่น scaleBrushes, noStroke, fill, fillBleed, circle เป็นต้น การจำกัดนี้ช่วยให้โมเดลสร้างภาพที่ดูเหมือนสีน้ำมากขึ้น โดยเฉพาะเมื่อใช้เมธอด fillBleed ที่ควบคุมการไหลของหมึกPool: ฟังก์ชันรางวัลเพื่อรสชาติศิลปะ 🎨Pool นี้ประกอบด้วยภาพวาดที่สร้างโดยโมเดล AI จำนวน 178 ภาพ ซึ่งแบ่งออกเป็น 2 ระดับตามความชอบส่วนตัวของผู้สร้างสรรค์ ได้แก่ "love" และ "okay" ภาพเหล่านี้สร้างขึ้นจากโมเดล Open Weight 4 ตัว โดยใช้ p5.brush sketch และอ้างอิงจากภาพถ่ายดอกชบาที่ได้รับอนุญาตให้ใช้งานได้อย่างเปิดเผยโมเดล Vision จะให้ข้อเสนอแนะที่เป็นลายลักษณ์อักษรสำหรับแต่ละ sketch และผ่านการปรับปรุง 3 รอบ สุดท้าย ภาพที่เสร็จสมบูรณ์จะถูกให้คะแนนทีละภาพ และ 178 ภาพนี้คือภาพที่ผ่านเกณฑ์สิ่งที่น่าสนใจคือ โมเดลจะเรียนรู้ที่จะเลียนแบบสิ่งที่อยู่ใน Pool หากเราเปลี่ยนชุดข้อมูล ฟังก์ชันรางวัลก็จะเปลี่ยนไปโดยอัตโนมัติโดยไม่ต้องแก้ไขโค้ดแม้แต่บรรทัดเดียวการเปรียบเทียบโมเดลประเมินผล 📊มีโมเดลประเมินผล 2 ตัวที่ทำงานแตกต่างกัน:HPSv3: เป็น Preference Model ขนาด 7B ที่ให้คะแนนว่าคนทั่วไปจะชอบภาพนั้นมากน้อยเพียงใด โดยฝึกฝนจากชุดข้อมูลการเลือกภาพจำนวนมากPairwise Judge (Qwen3-VL-30B-A3B-Instruct): เป็นโมเดล Vision ทั่วไปที่เปรียบเทียบภาพที่สร้างขึ้นกับภาพอ้างอิง 4 ภาพจาก Pool และให้คะแนนตามสัดส่วนการชนะการเปรียบเทียบผู้สร้างสรรค์ได้ทดลองฝึกฝน 3 รัน โดยแตกต่างกันที่น้ำหนัก (weight) ที่แบ่งให้กับโมเดลประเมินผลทั้งสองตัว:hps-only: ใช้ HPSv3 เพียงอย่างเดียว เพื่อทดสอบว่าไปป์ไลน์สามารถเรียนรู้ได้หรือไม่hps + judge (w=0.5): ผสมผสาน HPSv3 และ Pairwise Judge ด้วยน้ำหนักเท่ากันhps + judge (w=0.2): ผสมผสาน HPSv3 และ Pairwise Judge โดย Pairwise Judge มีน้ำหนักน้อยกว่าผลการทดลองแสดงให้เห็นว่า Pool ที่สร้างขึ้นด้วยมือสามารถชี้นำนโยบาย (policy) ของโมเดลได้ข้อควรระวังในการฝึกฝน ⚠️การขาดภาพวาดที่มนุษย์สร้างสรรค์: Pool ที่ใช้ส่วนใหญ่เป็นภาพที่สร้างโดย AI ซึ่งเป็นข้อจำกัด เนื่องจากภาพวาดสีน้ำที่ใช้ p5.brush และมีโค้ดให้ศึกษาได้นั้นมีจำนวนจำกัดการปรับพารามิเตอร์ LoRA: การตั้งค่า target_modules สำหรับโมเดลประเภท Mixture of Experts (MoE) เช่น Qwen/Qwen3.5-35B-A3B ต้องได้รับการปรับอย่างระมัดระวัง เพื่อให้ Adapter สามารถฝึกฝนกับทุก Layer ที่เกี่ยวข้องได้สรุปการฝึกฝนโมเดล AI ให้วาดภาพสีน้ำด้วย TRL และ OpenEnv เป็นตัวอย่างที่น่าสนใจของการนำเทคนิค Reinforcement Learning มาใช้กับความชอบทางศิลปะ แสดงให้เห็นว่า AI สามารถเรียนรู้และสร้างสรรค์ผลงานที่มีสไตล์เฉพาะตัวได้ โดยอาศัยการออกแบบฟังก์ชันรางวัลที่เหมาะสม และการใช้เครื่องมือ Open Source ที่มีประสิทธิภาพ#AIArt #Watercolour #TRL #OpenAIhttps://huggingface.co/blog/train-to-paint-with-code4 Comments 0 Shares 6K Views 0 Reviews-
การฝึกโมเดลให้สร้างสรรค์งานศิลปะตามรสนิยมส่วนตัวเป็นแนวคิดที่ท้าทายมากการฝึกโมเดลให้สร้างสรรค์งานศิลปะตามรสนิยมส่วนตัวเป็นแนวคิดที่ท้าทายมาก
-
React
- Reply
- 2026-09-07 17:00:16
-
-
การให้ฟีดแบ็กด้วยเสียง: อนาคตของการสื่อสารกับลูกค้า 🗣️
เคยไหมที่รู้สึกเบื่อหน่ายกับการต้องรอสายคอลเซ็นเตอร์นานๆ หรือกรอกแบบสอบถามที่ยาวเหยียด? ในยุคที่ทุกอย่างรวดเร็ว การให้ฟีดแบ็กกับธุรกิจต่างๆ ก็กำลังจะเปลี่ยนไปเช่นกัน เทคโนโลยีใหม่ๆ กำลังทำให้การแสดงความคิดเห็น ไม่ว่าจะเป็นคำชมหรือคำติ กลายเป็นเรื่องง่ายและเป็นธรรมชาติมากขึ้น
ทำไมการให้ฟีดแบ็กด้วยเสียงถึงน่าสนใจ?
ในอดีต การให้ฟีดแบ็กมักจะจำกัดอยู่แค่การเขียนอีเมล การโทรศัพท์ หรือการกรอกแบบฟอร์ม ซึ่งหลายครั้งก็ใช้เวลานานและน่าเบื่อ แต่ปัจจุบัน ผู้คนจำนวนมากเปิดใจที่จะแสดงความคิดเห็นสั้นๆ ผ่านเสียงของตัวเอง มากกว่าการต้องรอสายหรือพิมพ์ข้อความยาวๆ
"เราก้าวถึงจุดเปลี่ยนในช่วงสองปีที่ผ่านมา" คุณ Karan Gupta ซีอีโอของ Voicebox สตาร์ทอัพด้านการเก็บฟีดแบ็กด้วยเสียงกล่าว "เสียงที่บันทึกได้ในตอนนี้มีความแม่นยำและรวดเร็ว"
Voicebox: เปลี่ยนเสียงของคุณให้เป็นฟีดแบ็ก
Voicebox เป็นแพลตฟอร์มที่ออกแบบมาเพื่อรับฟีดแบ็กจากลูกค้าผ่านการบันทึกเสียงบนโทรศัพท์มือถือ วิธีการใช้งานง่ายมาก เพียงแค่สแกน QR Code หรือแตะโทรศัพท์กับชิป NFC ที่ร้านค้า ลูกค้าก็สามารถพูดสิ่งที่ต้องการได้ทันที
ระบบจะทำการถอดเสียงคำพูดเหล่านั้นโดยอัตโนมัติ และส่งไปยังแดชบอร์ดของบริษัท พร้อมการวิเคราะห์อารมณ์ (Sentiment Analysis) หากจำเป็น บริษัทก็สามารถติดต่อกลับผ่านอีเมลได้
ฟีดแบ็กจากทุกที่ ทุกสถานการณ์
Voicebox ไม่ได้จำกัดอยู่แค่ในร้านค้าเท่านั้น แต่ยังขยายไปสู่การใช้งานในหลากหลายรูปแบบ:
- สนามบิน: นักเดินทางสามารถให้ฟีดแบ็กเกี่ยวกับความสะอาดของห้องน้ำ หรือทิศทางของประตูขึ้นเครื่อง
- งานอีเวนต์: ผู้เข้าร่วมงานสามารถแบ่งปันความรู้สึกหรือข้อเสนอแนะเกี่ยวกับงานได้
- การเดินทาง: คุณสามารถให้ความเห็นเกี่ยวกับร้านตัดผม หรือให้คำแนะนำในการเดินทางไปยังโรงพยาบาลต่างๆ
สู่การรีวิวแบบบอกต่อ
Voicebox กำลังพัฒนาระบบ "Directory" ที่จะช่วยให้ผู้ใช้สามารถค้นหาว่าคนอื่นกำลังพูดถึงธุรกิจหรือสถานที่ต่างๆ ว่าอย่างไรบ้าง ทำให้การให้ฟีดแบ็กด้วยเสียง ไม่ใช่แค่เครื่องมือสำหรับธุรกิจเท่านั้น แต่ยังกลายเป็นแหล่งข้อมูลสาธารณะที่คล้ายกับ Google Maps ที่รวบรวมรีวิวจากเสียงของผู้คน
แนวคิดนี้สอดคล้องกับเทรนด์ซอฟต์แวร์ที่เน้นความรู้สึกเป็นธรรมชาติ การใช้เสียงพูดในการสื่อสารอาจกลายเป็นเรื่องปกติ จนทำให้การพิมพ์ด้วยนิ้วบนสมาร์ทโฟนดูเป็นเรื่องล้าสมัยไปเลย
อนาคตของการสื่อสาร
การให้ฟีดแบ็กด้วยเสียงกำลังเปลี่ยนแปลงวิธีที่ลูกค้ามีปฏิสัมพันธ์กับแบรนด์ต่างๆ ทำให้การแสดงความคิดเห็นเป็นเรื่องง่าย สะดวก และเป็นธรรมชาติมากขึ้น นี่อาจเป็นจุดเริ่มต้นของการสื่อสารที่ทรงพลังและเข้าถึงง่ายกว่าที่เคยเป็นมา
#VoiceFeedback #CustomerService #AI #VoiceTech #FutureOfFeedback
ขอบคุณ แหล่งข้อมูล
https://www.wired.com/story/whispering-complaints-into-your-phone-may-be-the-future-of-customer-feedback/การให้ฟีดแบ็กด้วยเสียง: อนาคตของการสื่อสารกับลูกค้า 🗣️เคยไหมที่รู้สึกเบื่อหน่ายกับการต้องรอสายคอลเซ็นเตอร์นานๆ หรือกรอกแบบสอบถามที่ยาวเหยียด? ในยุคที่ทุกอย่างรวดเร็ว การให้ฟีดแบ็กกับธุรกิจต่างๆ ก็กำลังจะเปลี่ยนไปเช่นกัน เทคโนโลยีใหม่ๆ กำลังทำให้การแสดงความคิดเห็น ไม่ว่าจะเป็นคำชมหรือคำติ กลายเป็นเรื่องง่ายและเป็นธรรมชาติมากขึ้นทำไมการให้ฟีดแบ็กด้วยเสียงถึงน่าสนใจ?ในอดีต การให้ฟีดแบ็กมักจะจำกัดอยู่แค่การเขียนอีเมล การโทรศัพท์ หรือการกรอกแบบฟอร์ม ซึ่งหลายครั้งก็ใช้เวลานานและน่าเบื่อ แต่ปัจจุบัน ผู้คนจำนวนมากเปิดใจที่จะแสดงความคิดเห็นสั้นๆ ผ่านเสียงของตัวเอง มากกว่าการต้องรอสายหรือพิมพ์ข้อความยาวๆ"เราก้าวถึงจุดเปลี่ยนในช่วงสองปีที่ผ่านมา" คุณ Karan Gupta ซีอีโอของ Voicebox สตาร์ทอัพด้านการเก็บฟีดแบ็กด้วยเสียงกล่าว "เสียงที่บันทึกได้ในตอนนี้มีความแม่นยำและรวดเร็ว"Voicebox: เปลี่ยนเสียงของคุณให้เป็นฟีดแบ็กVoicebox เป็นแพลตฟอร์มที่ออกแบบมาเพื่อรับฟีดแบ็กจากลูกค้าผ่านการบันทึกเสียงบนโทรศัพท์มือถือ วิธีการใช้งานง่ายมาก เพียงแค่สแกน QR Code หรือแตะโทรศัพท์กับชิป NFC ที่ร้านค้า ลูกค้าก็สามารถพูดสิ่งที่ต้องการได้ทันทีระบบจะทำการถอดเสียงคำพูดเหล่านั้นโดยอัตโนมัติ และส่งไปยังแดชบอร์ดของบริษัท พร้อมการวิเคราะห์อารมณ์ (Sentiment Analysis) หากจำเป็น บริษัทก็สามารถติดต่อกลับผ่านอีเมลได้ฟีดแบ็กจากทุกที่ ทุกสถานการณ์Voicebox ไม่ได้จำกัดอยู่แค่ในร้านค้าเท่านั้น แต่ยังขยายไปสู่การใช้งานในหลากหลายรูปแบบ:สนามบิน: นักเดินทางสามารถให้ฟีดแบ็กเกี่ยวกับความสะอาดของห้องน้ำ หรือทิศทางของประตูขึ้นเครื่องงานอีเวนต์: ผู้เข้าร่วมงานสามารถแบ่งปันความรู้สึกหรือข้อเสนอแนะเกี่ยวกับงานได้การเดินทาง: คุณสามารถให้ความเห็นเกี่ยวกับร้านตัดผม หรือให้คำแนะนำในการเดินทางไปยังโรงพยาบาลต่างๆสู่การรีวิวแบบบอกต่อVoicebox กำลังพัฒนาระบบ "Directory" ที่จะช่วยให้ผู้ใช้สามารถค้นหาว่าคนอื่นกำลังพูดถึงธุรกิจหรือสถานที่ต่างๆ ว่าอย่างไรบ้าง ทำให้การให้ฟีดแบ็กด้วยเสียง ไม่ใช่แค่เครื่องมือสำหรับธุรกิจเท่านั้น แต่ยังกลายเป็นแหล่งข้อมูลสาธารณะที่คล้ายกับ Google Maps ที่รวบรวมรีวิวจากเสียงของผู้คนแนวคิดนี้สอดคล้องกับเทรนด์ซอฟต์แวร์ที่เน้นความรู้สึกเป็นธรรมชาติ การใช้เสียงพูดในการสื่อสารอาจกลายเป็นเรื่องปกติ จนทำให้การพิมพ์ด้วยนิ้วบนสมาร์ทโฟนดูเป็นเรื่องล้าสมัยไปเลยอนาคตของการสื่อสารการให้ฟีดแบ็กด้วยเสียงกำลังเปลี่ยนแปลงวิธีที่ลูกค้ามีปฏิสัมพันธ์กับแบรนด์ต่างๆ ทำให้การแสดงความคิดเห็นเป็นเรื่องง่าย สะดวก และเป็นธรรมชาติมากขึ้น นี่อาจเป็นจุดเริ่มต้นของการสื่อสารที่ทรงพลังและเข้าถึงง่ายกว่าที่เคยเป็นมา#VoiceFeedback #CustomerService #AI #VoiceTech #FutureOfFeedbackhttps://www.wired.com/story/whispering-complaints-into-your-phone-may-be-the-future-of-customer-feedback/7 Comments 0 Shares 6K Views 0 Reviews -
สรุปดราม่า "Anthropic Settlement": นักเขียนโวย สำนักพิมพ์-เอเยนต์ "โกง" ค่าชดเชย AI 💰
วงการวรรณกรรมกำลังร้อนระอุ เมื่อนักเขียนจำนวนมากออกมาแสดงความไม่พอใจต่อการจัดการค่าชดเชยจากคดีความลิขสิทธิ์กับ Anthropic บริษัท AI ชื่อดัง โดยมีรายงานว่าสำนักพิมพ์และตัวแทนนักเขียนบางรายอาจกำลังพยายามเคลมส่วนแบ่งมากกว่าที่ควรจะเป็น
ที่มาของ "Anthropic Settlement" 📜
เรื่องนี้เริ่มต้นขึ้นหลังจาก Anthropic ถูกฟ้องร้องในข้อหาละเมิดลิขสิทธิ์จากการนำผลงานของนักเขียนไปใช้ฝึกโมเดล AI แม้ว่าศาลจะตัดสินว่าการฝึก AI ด้วยข้อมูลที่มีลิขสิทธิ์นั้นเข้าข่าย "การใช้งานโดยชอบธรรม" (Fair Use) แต่การนำผลงานไปเผยแพร่โดยไม่ได้รับอนุญาตนั้นผิดกฎหมาย
ท้ายที่สุด Anthropic ได้ทำข้อตกลงยอมความ โดยตกลงจ่ายเงินชดเชยกว่า 1.5 พันล้านดอลลาร์สหรัฐฯ ให้กับกลุ่มนักเขียนที่ได้รับผลกระทบ โดยการอนุมัติข้อตกลงนี้เสร็จสมบูรณ์เมื่อเดือนกรกฎาคมที่ผ่านมา ทำให้การจ่ายเงินสามารถดำเนินการต่อไปได้
เงื่อนไขการจ่ายเงินชดเชย 💸
ภายใต้ข้อตกลงดังกล่าว นักเขียนเจ้าของผลงานเกือบ 500,000 ชื่อ จะได้รับเงินชดเชย 3,000 ดอลลาร์สหรัฐฯ ต่อผลงานที่ถูกละเมิดลิขสิทธิ์
- หากหนังสือยังคงตีพิมพ์กับสำนักพิมพ์แบบดั้งเดิม: เงินชดเชยจะถูกแบ่ง 50-50 ระหว่างนักเขียนและสำนักพิมพ์
- หากหนังสือเป็นแบบ Self-published หรือสำนักพิมพ์ได้คืนสิทธิ์กลับมา (เช่น หนังสือหมดสัญญาและไม่ออกวางจำหน่ายแล้ว): นักเขียนควรได้รับเงินชดเชยเต็มจำนวน
ปัญหาที่นักเขียนเจอ: สำนักพิมพ์ "กินรวบ" หรือ "เคลมเกินสิทธิ์"? 🤔
แต่ดูเหมือนว่ากระบวนการจ่ายเงินจะไม่ราบรื่นอย่างที่คิด นักเขียนหลายคนเริ่มโพสต์บนโซเชียลมีเดียว่าพวกเขาได้รับอีเมลแจ้งว่ามี "บุคคลอื่น" มาเคลมสิทธิ์ในเงินชดเชยของตนเอง
ตัวอย่างที่ชัดเจนคือ April Henry นักเขียนแนวลึกลับและระทึกขวัญ ได้ตั้งคำถามถึงพฤติกรรมของสำนักพิมพ์ HarperCollins ที่เคลมสิทธิ์ในหนังสือเล่มหนึ่งของเธอ ซึ่งสิทธิ์ในการตีพิมพ์ได้หมดลงไปอย่างน้อย 17 ปีแล้ว และในวันเดียวกันเธอยังได้รับแจ้งว่า HarperCollins ถูกเพิ่มเป็นนายจ้างของเธอ ซึ่งไม่เป็นความจริง
Victoria Strauss จากบล็อกยอดนิยม Writers Beware ระบุว่า เธอได้รับข้อร้องเรียนจากนักเขียนใน 2 รูปแบบหลัก:
- สำนักพิมพ์พยายามเรียกร้องเงินชดเชยสำหรับผลงานที่ตนเองไม่มีสิทธิ์ตามกฎหมายอีกต่อไป (เพราะสิทธิ์ได้ถูกคืนกลับมาแล้ว)
- สำนักพิมพ์เรียกร้องเงินชดเชยเต็มจำนวน 100% ทั้งที่ตามกฎแล้วควรได้รับเพียง 50%
สาเหตุเกิดจากอะไร? ความผิดพลาด หรือเจตนา? 🧐
Strauss แสดงความเห็นว่า เธอ "ไม่ค่อยอยากจะเชื่อว่าเกิดจากเจตนาร้าย แต่เป็นความผิดพลาดจากการบันทึกข้อมูลที่ไม่ดี" และสำนักพิมพ์บางแห่งก็ยอมรับว่าเป็นความผิดพลาด และได้แจ้งให้ Anthropic แก้ไขแล้ว
ในทำนองเดียวกัน Mary Rasenberger CEO ของ Authors Guild กล่าวกับ The New York Times ว่า เธอไม่คิดว่านี่เป็นการ "ฉวยโอกาสของสำนักพิมพ์" และไม่เชื่อว่าสำนักพิมพ์พยายาม "เอาเปรียบนักเขียน" แต่เป็นผลลัพธ์ที่คาดเดาได้จากระบบการบันทึกข้อมูลที่หละหลวม และกระบวนการทำข้อตกลงที่ซับซ้อน
อย่างไรก็ตาม Strauss ก็ยอมรับว่าข้อร้องเรียนที่เธอได้รับนั้นเป็นเพียง "เศษเสี้ยวเล็กๆ" เท่านั้น แต่จำนวนรายงานที่ผิดปกติ และรูปแบบข้อผิดพลาดที่ซ้ำๆ กัน ทำให้น่าสงสัยว่านี่อาจไม่ใช่แค่ปัญหาเล็กๆ น้อยๆ แต่เป็นปัญหาที่ "แพร่หลายและเป็นระบบ"
ไม่ใช่แค่สำนักพิมพ์... ตัวแทนนักเขียนก็ถูกกล่าวหา! 😨
นอกจากสำนักพิมพ์แล้ว Strauss ยังได้รับข้อร้องเรียนว่า ตัวแทนนักเขียน (Literary Agencies) หลายแห่งก็กำลังพยายามเข้ามาเคลมส่วนแบ่งในเงินชดเชยนี้ด้วย ซึ่ง Strauss มองว่าน่าประหลาดใจ เพราะ "ตัวแทนนักเขียนไม่ใช่เจ้าของลิขสิทธิ์ในหนังสือที่พวกเขาขาย"
Courtney Milan (นามปากกาของ Heidi Bond) อดีตทนายความและศาสตราจารย์ด้านกฎหมาย แสดงความเห็นอย่างตรงไปตรงมาบนโซเชียลมีเดียว่า "เห็นได้ชัดว่าตัวแทนนักเขียนบางคนกำลังพยายามเคลมส่วนแบ่งจาก Anthropic Settlement และฉันไม่คิดว่าพวกเขาควรทำเลยสักนิด อะไรกันวะ หยุดพฤติกรรมแบบนี้เถอะ!"
Milan และ Authors Guild ได้ให้ข้อมูลเพิ่มเติมเกี่ยวกับวิธีการที่นักเขียนสามารถ โต้แย้งการจัดสรรเงินชดเชย ของตนเองได้ ซึ่งมีประเด็นที่ซับซ้อน เช่น การพิจารณาว่าสิทธิ์ในการตีพิมพ์หนังสือเล่มนั้นๆ ได้ถูกคืนกลับมาก่อนวันที่ 10 สิงหาคม 2022 (ซึ่งเป็น "วันที่ดาวน์โหลด" ในข้อตกลง) หรือไม่ หากคืนมาก่อนวันดังกล่าว นักเขียนจึงจะสามารถเคลมเงิน 100% ได้
สรุป: ต้องจับตาดูสถานการณ์อย่างใกล้ชิด 👀
เหตุการณ์นี้สะท้อนให้เห็นถึงความซับซ้อนในการจัดการผลประโยชน์ที่เกี่ยวข้องกับ AI และลิขสิทธิ์ รวมถึงความสำคัญของความโปร่งใสและระบบการจัดการข้อมูลที่ถูกต้องของทุกฝ่ายที่เกี่ยวข้อง นักเขียนจำนวนมากกำลังจับตาดูสถานการณ์นี้อย่างใกล้ชิด และหวังว่าจะได้รับส่วนแบ่งค่าชดเชยที่เป็นธรรมตามสิทธิ์ของตนเอง
#Anthropic #Copyright #AI #Authors #Publishers #LiteraryAgents #Settlement
ขอบคุณ แหล่งข้อมูล
https://techcrunch.com/2026/09/06/authors-push-back-as-publishers-and-agents-seek-share-of-anthropic-settlement/สรุปดราม่า "Anthropic Settlement": นักเขียนโวย สำนักพิมพ์-เอเยนต์ "โกง" ค่าชดเชย AI 💰วงการวรรณกรรมกำลังร้อนระอุ เมื่อนักเขียนจำนวนมากออกมาแสดงความไม่พอใจต่อการจัดการค่าชดเชยจากคดีความลิขสิทธิ์กับ Anthropic บริษัท AI ชื่อดัง โดยมีรายงานว่าสำนักพิมพ์และตัวแทนนักเขียนบางรายอาจกำลังพยายามเคลมส่วนแบ่งมากกว่าที่ควรจะเป็นที่มาของ "Anthropic Settlement" 📜เรื่องนี้เริ่มต้นขึ้นหลังจาก Anthropic ถูกฟ้องร้องในข้อหาละเมิดลิขสิทธิ์จากการนำผลงานของนักเขียนไปใช้ฝึกโมเดล AI แม้ว่าศาลจะตัดสินว่าการฝึก AI ด้วยข้อมูลที่มีลิขสิทธิ์นั้นเข้าข่าย "การใช้งานโดยชอบธรรม" (Fair Use) แต่การนำผลงานไปเผยแพร่โดยไม่ได้รับอนุญาตนั้นผิดกฎหมายท้ายที่สุด Anthropic ได้ทำข้อตกลงยอมความ โดยตกลงจ่ายเงินชดเชยกว่า 1.5 พันล้านดอลลาร์สหรัฐฯ ให้กับกลุ่มนักเขียนที่ได้รับผลกระทบ โดยการอนุมัติข้อตกลงนี้เสร็จสมบูรณ์เมื่อเดือนกรกฎาคมที่ผ่านมา ทำให้การจ่ายเงินสามารถดำเนินการต่อไปได้เงื่อนไขการจ่ายเงินชดเชย 💸ภายใต้ข้อตกลงดังกล่าว นักเขียนเจ้าของผลงานเกือบ 500,000 ชื่อ จะได้รับเงินชดเชย 3,000 ดอลลาร์สหรัฐฯ ต่อผลงานที่ถูกละเมิดลิขสิทธิ์หากหนังสือยังคงตีพิมพ์กับสำนักพิมพ์แบบดั้งเดิม: เงินชดเชยจะถูกแบ่ง 50-50 ระหว่างนักเขียนและสำนักพิมพ์หากหนังสือเป็นแบบ Self-published หรือสำนักพิมพ์ได้คืนสิทธิ์กลับมา (เช่น หนังสือหมดสัญญาและไม่ออกวางจำหน่ายแล้ว): นักเขียนควรได้รับเงินชดเชยเต็มจำนวนปัญหาที่นักเขียนเจอ: สำนักพิมพ์ "กินรวบ" หรือ "เคลมเกินสิทธิ์"? 🤔แต่ดูเหมือนว่ากระบวนการจ่ายเงินจะไม่ราบรื่นอย่างที่คิด นักเขียนหลายคนเริ่มโพสต์บนโซเชียลมีเดียว่าพวกเขาได้รับอีเมลแจ้งว่ามี "บุคคลอื่น" มาเคลมสิทธิ์ในเงินชดเชยของตนเองตัวอย่างที่ชัดเจนคือ April Henry นักเขียนแนวลึกลับและระทึกขวัญ ได้ตั้งคำถามถึงพฤติกรรมของสำนักพิมพ์ HarperCollins ที่เคลมสิทธิ์ในหนังสือเล่มหนึ่งของเธอ ซึ่งสิทธิ์ในการตีพิมพ์ได้หมดลงไปอย่างน้อย 17 ปีแล้ว และในวันเดียวกันเธอยังได้รับแจ้งว่า HarperCollins ถูกเพิ่มเป็นนายจ้างของเธอ ซึ่งไม่เป็นความจริงVictoria Strauss จากบล็อกยอดนิยม Writers Beware ระบุว่า เธอได้รับข้อร้องเรียนจากนักเขียนใน 2 รูปแบบหลัก:สำนักพิมพ์พยายามเรียกร้องเงินชดเชยสำหรับผลงานที่ตนเองไม่มีสิทธิ์ตามกฎหมายอีกต่อไป (เพราะสิทธิ์ได้ถูกคืนกลับมาแล้ว)สำนักพิมพ์เรียกร้องเงินชดเชยเต็มจำนวน 100% ทั้งที่ตามกฎแล้วควรได้รับเพียง 50%สาเหตุเกิดจากอะไร? ความผิดพลาด หรือเจตนา? 🧐Strauss แสดงความเห็นว่า เธอ "ไม่ค่อยอยากจะเชื่อว่าเกิดจากเจตนาร้าย แต่เป็นความผิดพลาดจากการบันทึกข้อมูลที่ไม่ดี" และสำนักพิมพ์บางแห่งก็ยอมรับว่าเป็นความผิดพลาด และได้แจ้งให้ Anthropic แก้ไขแล้วในทำนองเดียวกัน Mary Rasenberger CEO ของ Authors Guild กล่าวกับ The New York Times ว่า เธอไม่คิดว่านี่เป็นการ "ฉวยโอกาสของสำนักพิมพ์" และไม่เชื่อว่าสำนักพิมพ์พยายาม "เอาเปรียบนักเขียน" แต่เป็นผลลัพธ์ที่คาดเดาได้จากระบบการบันทึกข้อมูลที่หละหลวม และกระบวนการทำข้อตกลงที่ซับซ้อนอย่างไรก็ตาม Strauss ก็ยอมรับว่าข้อร้องเรียนที่เธอได้รับนั้นเป็นเพียง "เศษเสี้ยวเล็กๆ" เท่านั้น แต่จำนวนรายงานที่ผิดปกติ และรูปแบบข้อผิดพลาดที่ซ้ำๆ กัน ทำให้น่าสงสัยว่านี่อาจไม่ใช่แค่ปัญหาเล็กๆ น้อยๆ แต่เป็นปัญหาที่ "แพร่หลายและเป็นระบบ"ไม่ใช่แค่สำนักพิมพ์... ตัวแทนนักเขียนก็ถูกกล่าวหา! 😨นอกจากสำนักพิมพ์แล้ว Strauss ยังได้รับข้อร้องเรียนว่า ตัวแทนนักเขียน (Literary Agencies) หลายแห่งก็กำลังพยายามเข้ามาเคลมส่วนแบ่งในเงินชดเชยนี้ด้วย ซึ่ง Strauss มองว่าน่าประหลาดใจ เพราะ "ตัวแทนนักเขียนไม่ใช่เจ้าของลิขสิทธิ์ในหนังสือที่พวกเขาขาย"Courtney Milan (นามปากกาของ Heidi Bond) อดีตทนายความและศาสตราจารย์ด้านกฎหมาย แสดงความเห็นอย่างตรงไปตรงมาบนโซเชียลมีเดียว่า "เห็นได้ชัดว่าตัวแทนนักเขียนบางคนกำลังพยายามเคลมส่วนแบ่งจาก Anthropic Settlement และฉันไม่คิดว่าพวกเขาควรทำเลยสักนิด อะไรกันวะ หยุดพฤติกรรมแบบนี้เถอะ!"Milan และ Authors Guild ได้ให้ข้อมูลเพิ่มเติมเกี่ยวกับวิธีการที่นักเขียนสามารถ โต้แย้งการจัดสรรเงินชดเชย ของตนเองได้ ซึ่งมีประเด็นที่ซับซ้อน เช่น การพิจารณาว่าสิทธิ์ในการตีพิมพ์หนังสือเล่มนั้นๆ ได้ถูกคืนกลับมาก่อนวันที่ 10 สิงหาคม 2022 (ซึ่งเป็น "วันที่ดาวน์โหลด" ในข้อตกลง) หรือไม่ หากคืนมาก่อนวันดังกล่าว นักเขียนจึงจะสามารถเคลมเงิน 100% ได้สรุป: ต้องจับตาดูสถานการณ์อย่างใกล้ชิด 👀เหตุการณ์นี้สะท้อนให้เห็นถึงความซับซ้อนในการจัดการผลประโยชน์ที่เกี่ยวข้องกับ AI และลิขสิทธิ์ รวมถึงความสำคัญของความโปร่งใสและระบบการจัดการข้อมูลที่ถูกต้องของทุกฝ่ายที่เกี่ยวข้อง นักเขียนจำนวนมากกำลังจับตาดูสถานการณ์นี้อย่างใกล้ชิด และหวังว่าจะได้รับส่วนแบ่งค่าชดเชยที่เป็นธรรมตามสิทธิ์ของตนเอง#Anthropic #Copyright #AI #Authors #Publishers #LiteraryAgents #Settlementhttps://techcrunch.com/2026/09/06/authors-push-back-as-publishers-and-agents-seek-share-of-anthropic-settlement/5 Comments 0 Shares 6K Views 0 Reviews -
นวัตกรรม AI สู่ขอบเขต: วิธีติดตั้งและปรับปรุงโมเดลบน NVIDIA Jetson
การประมวลผล AI ขั้นสูงและการทำงานแบบ Agentic AI ที่ขอบเขต (Edge) เคยเป็นเรื่องที่ซับซ้อนกว่าที่ควรจะเป็น เนื่องจากโมเดลที่สามารถทำการวิเคราะห์แบบหลายขั้นตอนมักมีขนาดใหญ่เกินไปที่จะทำงานบนฮาร์ดแวร์ขนาดเล็กที่ขอบเขตได้โดยตรง แต่ปัจจุบันสถานการณ์ได้เปลี่ยนไปแล้ว! ด้วยการมาถึงของโมเดลขนาดกะทัดรัดที่เปิดให้ใช้งานในปี 2026 ทำให้ความสามารถในการวิเคราะห์และสร้างสรรค์แบบ Agentic AI ที่เคยต้องการระบบขนาดใหญ่ใน Data Center สามารถทำงานบน NVIDIA Jetson ได้แล้ว
AI ยุคใหม่ที่ทำงานได้รวดเร็วและชาญฉลาดขึ้น
โมเดล AI ที่พัฒนาขึ้นใหม่ เช่น Nemotron 3.5 Lightning ที่ใช้สถาปัตยกรรมแบบ Mixture-of-Experts (MoE) มีพารามิเตอร์รวม 30 พันล้านตัว แต่จะใช้งานเพียง 3 พันล้านตัวต่อโทเค็น ทำให้เหมาะสำหรับงาน Agent ที่หลากหลาย ในขณะที่ Qwen3.8-27B เป็นโมเดลแบบ Dense ที่ใช้งานทั้ง 27 พันล้านพารามิเตอร์ ทำให้แต่ละโมเดลมีความเหมาะสมกับปริมาณงาน Agent ที่แตกต่างกัน
เทคนิคการปรับปรุงประสิทธิภาพอย่าง NVFP4 Quantization ช่วยลดภาระการประมวลผลและหน่วยความจำที่โมเดลต้องการ และ Speculative Decoding ที่สามารถสร้างโทเค็นที่ยอมรับได้หลายตัวต่อหนึ่งรอบการตรวจสอบ เมื่อทำงานร่วมกัน เทคนิคเหล่านี้สามารถเพิ่มความเร็วในการถอดรหัส (decode throughput) ได้สูงถึง 6.28 เท่า เมื่อเทียบกับการใช้ BF16 บน Jetson
การเลือกโมเดลที่เหมาะสมกับการใช้งาน
การเลือกโมเดลที่เหมาะสมกับงาน Agent ของคุณเป็นสิ่งสำคัญ
- Nemotron 3.5 Lightning: เหมาะสำหรับเวิร์กโฟลว์ที่ต้องการการตอบสนองที่รวดเร็ว (response-heavy workflows) เนื่องจากสามารถสร้างโทเค็นได้ไว ช่วยลดระยะเวลาโดยรวมของกระบวนการ
- Qwen3.8-27B: เหมาะสำหรับงานที่ต้องการการตัดสินใจที่ซับซ้อนน้อยครั้ง แต่ใช้เวลาในการสร้างการตอบสนองแต่ละครั้งนานขึ้น
ควรทดสอบประสิทธิภาพของทั้งสองโมเดลกับรูปแบบการตัดสินใจ การใช้เครื่องมือ และรูปแบบการตอบสนองที่แอปพลิเคชันของคุณต้องการ ก่อนตัดสินใจเลือก
ปรับปรุงประสิทธิภาพการประมวลผล AI บน Jetson
การปรับปรุงประสิทธิภาพการประมวลผล (Inference) ของโมเดล AI บน Jetson สามารถทำได้ด้วยสองเทคนิคหลักที่ทำงานเสริมกัน:
- NVFP4 Quantization: ลดปริมาณงานและหน่วยความจำที่ต้องใช้ในการประมวลผลโมเดล โดยการลดความแม่นยำของค่าตัวเลข ทำให้การสร้างโทเค็นเร็วขึ้นและใช้หน่วยความจำน้อยลง โดยยังคงคุณภาพใกล้เคียงกับ BF16
- Speculative Decoding: เพิ่มจำนวนโทเค็นที่ได้จากการประมวลผลแต่ละครั้ง โดยใช้โมเดลขนาดเล็ก (Draft Model) เสนอโทเค็นหลายตัว จากนั้นโมเดลหลักจะตรวจสอบโทเค็นเหล่านั้นพร้อมกัน ซึ่งหากโมเดลหลักยอมรับโทเค็นหลายตัว การประมวลผลก็จะก้าวไปได้หลายโทเค็นในหนึ่งรอบการตรวจสอบ
เมื่อรวมสองเทคนิคนี้เข้าด้วยกัน จะช่วยเพิ่มประสิทธิภาพได้มากกว่าการใช้เทคนิคใดเทคนิคหนึ่งเพียงอย่างเดียว
การเลือกวิธีการ Speculative Decoding ที่เหมาะสม
วิธีการที่ใช้ในการสร้าง Draft Tokens แต่ละวิธีมีผลต่อต้นทุนและความแม่นยำของข้อเสนอ เช่น
- MTP: ใช้ Prediction Heads ที่ฝึกร่วมกับโมเดลหลัก
- DFlash: ใช้ Draft Model แบบ Diffusion-based ในการเสนอ Block ของโทเค็นแบบขนาน
- DSpark: พัฒนาต่อยอดจาก DFlash โดยมีการแก้ไข Draft และหยุดข้อเสนอที่ไม่ดีตั้งแต่เนิ่นๆ ทำให้เร็วกว่าเมื่อมี Checkpoint ที่ตรงกัน แต่รองรับ Checkpoint น้อยกว่า
ข้อควรจำ: การตั้งค่า Speculative Decoding ที่เร็วที่สุดอาจแตกต่างกันไปในแต่ละโมเดล Nemotron 3.5 Lightning ทำงานได้ดีที่สุดกับ DSpark ในขณะที่ Qwen3.8-27B ทำงานได้ดีที่สุดกับ DFlash2 ดังนั้น นักพัฒนาควรทดสอบวิธีการและ Draft Checkpoint ต่างๆ กับโมเดลเป้าหมายของตนเอง
การติดตั้งและทดสอบโมเดลบน Jetson
สำหรับผู้ที่ใช้ Jetson AGX Thor หรือ Jetson AGX Orin และมี JetPack 7.2 พร้อมการตั้งค่า NVIDIA Container Runtime และ Docker สามารถติดตั้งโมเดลได้ดังนี้:
สำหรับ Nemotron 3.5 Lightning: (ใช้ NVFP4 ร่วมกับ DSpark)
docker run --gpus all -it --rm -v /tmp/cache:/data \

    nvcr.io/nvidia/pytorch:23.10-py3
จากนั้นรันคำสั่งภายใน Container:
python -m vllm.entrypoints.openai.api_server \

    --model nvidia/Nemotron-3.5-30B-Lightning \

    --tensor-parallel-size 1 \

    --engine-use-ray \

    --max-num-seqs 64 \

    --max-num-batched-tokens 4096 \

    --trust-remote-code \

    --quantization nvfp4 \

    --speculator-model nvidia/Nemotron-3.5-30B-Lightning \

    --speculator-args "method=dspark"
สำหรับ Qwen3.8-27B: (ใช้ NVFP4 ร่วมกับ DFlash2)
ใช้ Container เดียวกันที่เปิดด้วยคำสั่งข้างต้น แล้วรันคำสั่งนี้ภายใน Container:
python -m vllm.entrypoints.openai.api_server \

    --model Qwen/Qwen3.8-27B \

    --tensor-parallel-size 1 \

    --engine-use-ray \

    --max-num-seqs 64 \

    --max-num-batched-tokens 4096 \

    --trust-remote-code \

    --quantization nvfp4 \

    --speculator-model Qwen/Qwen3.8-27B \

    --speculator-args "method=dflash2"
การตรวจสอบประสิทธิภาพกับปริมาณงานจริง
แม้ว่า Benchmark ระดับโมเดลจะช่วยให้เลือกการตั้งค่า Speculative Decoding ที่เหมาะสมได้ แต่แอปพลิเคชันต่างๆ สร้างข้อความแตกต่างกัน และประสิทธิภาพก็อาจเปลี่ยนแปลงไปตามปริมาณงาน (Workload)
การทดสอบประสิทธิภาพด้วย Prompt ที่เป็นตัวแทนของแอปพลิเคชันจริงจึงเป็นสิ่งสำคัญ เพราะ Benchmark ทั่วไปไม่สามารถยืนยันได้ว่า Checkpoint ที่เลือกนั้นยังคงพฤติกรรมที่สำคัญต่อข้อมูลเฉพาะของคุณหรือไม่
ตัวอย่างเช่น Nemotron 3.5 Lightning กับ DSpark มีช่วงความเร็วตั้งแต่ 123.01 ถึง 138.02 Output Tokens/s ในขณะที่ Qwen3.8-27B กับ DFlash2 มีช่วงความเร็วตั้งแต่ 27.69 ถึง 34.44 Output Tokens/s ซึ่งตัวเลขนี้แตกต่างกันไปตามประเภทของงาน (เช่น การเขียน, การให้เหตุผล, การสรุป, หรือ Retrieval-Augmented Generation)
เมื่อไหร่ควรฝึก Custom Checkpoint?
สำหรับแอปพลิเคชันส่วนใหญ่ ควรเริ่มต้นด้วย Quantized Checkpoint และ Draft Model ที่มีอยู่แล้ว ซึ่งมักจะเพียงพอที่จะให้ความแม่นยำที่ดีและเพิ่มความเร็วได้อย่างมีประสิทธิภาพ โดยไม่ต้องฝึกโมเดลใหม่
หากการ Quantization ส่งผลให้ความแม่นยำลดลง สามารถใช้ NVIDIA Model Optimizer เพื่อปรับแต่งโมเดลที่ Quantized แล้ว ด้วยเทคนิค Quantization-Aware Training (QAT) หรือ Quantization-Aware Distillation (QAD)
ในทำนองเดียวกัน สำหรับ Speculative Decoding หาก Draft Checkpoint สาธารณะที่เข้ากันได้กับโมเดลของคุณให้ความเร่งน้อยกว่าที่คาดหวัง อาจจำเป็นต้องฝึก Speculator ที่เข้ากันได้ด้วยข้อมูลแอปพลิเคชันของคุณเอง
แหล่งข้อมูลเพิ่มเติม
- สำรวจโมเดล, ผลการ Benchmark, สูตรแนะนำ และการเปรียบเทียบประสิทธิภาพบนแพลตฟอร์ม Jetson ต่างๆ ได้ที่ [Jetson AI Lab Models](ขอบคุณ แหล่งข้อมูล
https://developer.nvidia.com/blog/frontier-reasoning-reaches-the-edge/jetson-ai-lab-models/) - ศึกษาคู่มือการติดตั้ง LLMs และ VLMs บน Jetson เพื่อดูคำแนะนำในการติดตั้งจริง: [Running LLMs and VLMs on Jetson tutorial](ขอบคุณ แหล่งข้อมูล
https://developer.nvidia.com/blog/frontier-reasoning-reaches-the-edge/running-llms-and-vlms-on-jetson-tutorial/) - เจาะลึกการใช้เทคนิคการปรับปรุงประสิทธิภาพด้วยคู่มือ Speculative Decoding: [Getting started with speculative decoding tutorial](ขอบคุณ แหล่งข้อมูล
https://developer.nvidia.com/blog/frontier-reasoning-reaches-the-edge/getting-started-with-speculative-decoding-tutorial/)
การนำ AI ขั้นสูงมาสู่ขอบเขตเปิดโอกาสใหม่ๆ มากมาย ตั้งแต่ผู้ช่วยในห้องโดยสารรถยนต์ การตรวจจับความผิดปกติแบบเรียลไทม์ ไปจนถึงหุ่นยนต์ที่ทำงานในสภาพแวดล้อมที่ท้าทาย ทำให้ผู้เชี่ยวชาญสามารถทำงานได้อย่างมีประสิทธิภาพมากขึ้น และระบบสำคัญก็ยังคงทำงานได้แม้ในขณะที่การเชื่อมต่ออินเทอร์เน็ตมีจำกัดหรือขาดหายไป
ขอบคุณ แหล่งข้อมูล
https://developer.nvidia.com/blog/frontier-reasoning-reaches-the-edge-how-to-deploy-and-optimize-models-on-nvidia-jetson/นวัตกรรม AI สู่ขอบเขต: วิธีติดตั้งและปรับปรุงโมเดลบน NVIDIA Jetsonการประมวลผล AI ขั้นสูงและการทำงานแบบ Agentic AI ที่ขอบเขต (Edge) เคยเป็นเรื่องที่ซับซ้อนกว่าที่ควรจะเป็น เนื่องจากโมเดลที่สามารถทำการวิเคราะห์แบบหลายขั้นตอนมักมีขนาดใหญ่เกินไปที่จะทำงานบนฮาร์ดแวร์ขนาดเล็กที่ขอบเขตได้โดยตรง แต่ปัจจุบันสถานการณ์ได้เปลี่ยนไปแล้ว! ด้วยการมาถึงของโมเดลขนาดกะทัดรัดที่เปิดให้ใช้งานในปี 2026 ทำให้ความสามารถในการวิเคราะห์และสร้างสรรค์แบบ Agentic AI ที่เคยต้องการระบบขนาดใหญ่ใน Data Center สามารถทำงานบน NVIDIA Jetson ได้แล้วAI ยุคใหม่ที่ทำงานได้รวดเร็วและชาญฉลาดขึ้นโมเดล AI ที่พัฒนาขึ้นใหม่ เช่น Nemotron 3.5 Lightning ที่ใช้สถาปัตยกรรมแบบ Mixture-of-Experts (MoE) มีพารามิเตอร์รวม 30 พันล้านตัว แต่จะใช้งานเพียง 3 พันล้านตัวต่อโทเค็น ทำให้เหมาะสำหรับงาน Agent ที่หลากหลาย ในขณะที่ Qwen3.8-27B เป็นโมเดลแบบ Dense ที่ใช้งานทั้ง 27 พันล้านพารามิเตอร์ ทำให้แต่ละโมเดลมีความเหมาะสมกับปริมาณงาน Agent ที่แตกต่างกันเทคนิคการปรับปรุงประสิทธิภาพอย่าง NVFP4 Quantization ช่วยลดภาระการประมวลผลและหน่วยความจำที่โมเดลต้องการ และ Speculative Decoding ที่สามารถสร้างโทเค็นที่ยอมรับได้หลายตัวต่อหนึ่งรอบการตรวจสอบ เมื่อทำงานร่วมกัน เทคนิคเหล่านี้สามารถเพิ่มความเร็วในการถอดรหัส (decode throughput) ได้สูงถึง 6.28 เท่า เมื่อเทียบกับการใช้ BF16 บน Jetsonการเลือกโมเดลที่เหมาะสมกับการใช้งานการเลือกโมเดลที่เหมาะสมกับงาน Agent ของคุณเป็นสิ่งสำคัญNemotron 3.5 Lightning: เหมาะสำหรับเวิร์กโฟลว์ที่ต้องการการตอบสนองที่รวดเร็ว (response-heavy workflows) เนื่องจากสามารถสร้างโทเค็นได้ไว ช่วยลดระยะเวลาโดยรวมของกระบวนการQwen3.8-27B: เหมาะสำหรับงานที่ต้องการการตัดสินใจที่ซับซ้อนน้อยครั้ง แต่ใช้เวลาในการสร้างการตอบสนองแต่ละครั้งนานขึ้นควรทดสอบประสิทธิภาพของทั้งสองโมเดลกับรูปแบบการตัดสินใจ การใช้เครื่องมือ และรูปแบบการตอบสนองที่แอปพลิเคชันของคุณต้องการ ก่อนตัดสินใจเลือกปรับปรุงประสิทธิภาพการประมวลผล AI บน Jetsonการปรับปรุงประสิทธิภาพการประมวลผล (Inference) ของโมเดล AI บน Jetson สามารถทำได้ด้วยสองเทคนิคหลักที่ทำงานเสริมกัน:NVFP4 Quantization: ลดปริมาณงานและหน่วยความจำที่ต้องใช้ในการประมวลผลโมเดล โดยการลดความแม่นยำของค่าตัวเลข ทำให้การสร้างโทเค็นเร็วขึ้นและใช้หน่วยความจำน้อยลง โดยยังคงคุณภาพใกล้เคียงกับ BF16Speculative Decoding: เพิ่มจำนวนโทเค็นที่ได้จากการประมวลผลแต่ละครั้ง โดยใช้โมเดลขนาดเล็ก (Draft Model) เสนอโทเค็นหลายตัว จากนั้นโมเดลหลักจะตรวจสอบโทเค็นเหล่านั้นพร้อมกัน ซึ่งหากโมเดลหลักยอมรับโทเค็นหลายตัว การประมวลผลก็จะก้าวไปได้หลายโทเค็นในหนึ่งรอบการตรวจสอบเมื่อรวมสองเทคนิคนี้เข้าด้วยกัน จะช่วยเพิ่มประสิทธิภาพได้มากกว่าการใช้เทคนิคใดเทคนิคหนึ่งเพียงอย่างเดียวการเลือกวิธีการ Speculative Decoding ที่เหมาะสมวิธีการที่ใช้ในการสร้าง Draft Tokens แต่ละวิธีมีผลต่อต้นทุนและความแม่นยำของข้อเสนอ เช่นMTP: ใช้ Prediction Heads ที่ฝึกร่วมกับโมเดลหลักDFlash: ใช้ Draft Model แบบ Diffusion-based ในการเสนอ Block ของโทเค็นแบบขนานDSpark: พัฒนาต่อยอดจาก DFlash โดยมีการแก้ไข Draft และหยุดข้อเสนอที่ไม่ดีตั้งแต่เนิ่นๆ ทำให้เร็วกว่าเมื่อมี Checkpoint ที่ตรงกัน แต่รองรับ Checkpoint น้อยกว่าข้อควรจำ: การตั้งค่า Speculative Decoding ที่เร็วที่สุดอาจแตกต่างกันไปในแต่ละโมเดล Nemotron 3.5 Lightning ทำงานได้ดีที่สุดกับ DSpark ในขณะที่ Qwen3.8-27B ทำงานได้ดีที่สุดกับ DFlash2 ดังนั้น นักพัฒนาควรทดสอบวิธีการและ Draft Checkpoint ต่างๆ กับโมเดลเป้าหมายของตนเองการติดตั้งและทดสอบโมเดลบน Jetsonสำหรับผู้ที่ใช้ Jetson AGX Thor หรือ Jetson AGX Orin และมี JetPack 7.2 พร้อมการตั้งค่า NVIDIA Container Runtime และ Docker สามารถติดตั้งโมเดลได้ดังนี้:สำหรับ Nemotron 3.5 Lightning: (ใช้ NVFP4 ร่วมกับ DSpark)docker run --gpus all -it --rm -v /tmp/cache:/data \ nvcr.io/nvidia/pytorch:23.10-py3จากนั้นรันคำสั่งภายใน Container:python -m vllm.entrypoints.openai.api_server \ --model nvidia/Nemotron-3.5-30B-Lightning \ --tensor-parallel-size 1 \ --engine-use-ray \ --max-num-seqs 64 \ --max-num-batched-tokens 4096 \ --trust-remote-code \ --quantization nvfp4 \ --speculator-model nvidia/Nemotron-3.5-30B-Lightning \ --speculator-args "method=dspark"สำหรับ Qwen3.8-27B: (ใช้ NVFP4 ร่วมกับ DFlash2)ใช้ Container เดียวกันที่เปิดด้วยคำสั่งข้างต้น แล้วรันคำสั่งนี้ภายใน Container:python -m vllm.entrypoints.openai.api_server \ --model Qwen/Qwen3.8-27B \ --tensor-parallel-size 1 \ --engine-use-ray \ --max-num-seqs 64 \ --max-num-batched-tokens 4096 \ --trust-remote-code \ --quantization nvfp4 \ --speculator-model Qwen/Qwen3.8-27B \ --speculator-args "method=dflash2"การตรวจสอบประสิทธิภาพกับปริมาณงานจริงแม้ว่า Benchmark ระดับโมเดลจะช่วยให้เลือกการตั้งค่า Speculative Decoding ที่เหมาะสมได้ แต่แอปพลิเคชันต่างๆ สร้างข้อความแตกต่างกัน และประสิทธิภาพก็อาจเปลี่ยนแปลงไปตามปริมาณงาน (Workload)การทดสอบประสิทธิภาพด้วย Prompt ที่เป็นตัวแทนของแอปพลิเคชันจริงจึงเป็นสิ่งสำคัญ เพราะ Benchmark ทั่วไปไม่สามารถยืนยันได้ว่า Checkpoint ที่เลือกนั้นยังคงพฤติกรรมที่สำคัญต่อข้อมูลเฉพาะของคุณหรือไม่ตัวอย่างเช่น Nemotron 3.5 Lightning กับ DSpark มีช่วงความเร็วตั้งแต่ 123.01 ถึง 138.02 Output Tokens/s ในขณะที่ Qwen3.8-27B กับ DFlash2 มีช่วงความเร็วตั้งแต่ 27.69 ถึง 34.44 Output Tokens/s ซึ่งตัวเลขนี้แตกต่างกันไปตามประเภทของงาน (เช่น การเขียน, การให้เหตุผล, การสรุป, หรือ Retrieval-Augmented Generation)เมื่อไหร่ควรฝึก Custom Checkpoint?สำหรับแอปพลิเคชันส่วนใหญ่ ควรเริ่มต้นด้วย Quantized Checkpoint และ Draft Model ที่มีอยู่แล้ว ซึ่งมักจะเพียงพอที่จะให้ความแม่นยำที่ดีและเพิ่มความเร็วได้อย่างมีประสิทธิภาพ โดยไม่ต้องฝึกโมเดลใหม่หากการ Quantization ส่งผลให้ความแม่นยำลดลง สามารถใช้ NVIDIA Model Optimizer เพื่อปรับแต่งโมเดลที่ Quantized แล้ว ด้วยเทคนิค Quantization-Aware Training (QAT) หรือ Quantization-Aware Distillation (QAD)ในทำนองเดียวกัน สำหรับ Speculative Decoding หาก Draft Checkpoint สาธารณะที่เข้ากันได้กับโมเดลของคุณให้ความเร่งน้อยกว่าที่คาดหวัง อาจจำเป็นต้องฝึก Speculator ที่เข้ากันได้ด้วยข้อมูลแอปพลิเคชันของคุณเองแหล่งข้อมูลเพิ่มเติมสำรวจโมเดล, ผลการ Benchmark, สูตรแนะนำ และการเปรียบเทียบประสิทธิภาพบนแพลตฟอร์ม Jetson ต่างๆ ได้ที่ [Jetson AI Lab Models](https://developer.nvidia.com/blog/frontier-reasoning-reaches-the-edge/jetson-ai-lab-models/)ศึกษาคู่มือการติดตั้ง LLMs และ VLMs บน Jetson เพื่อดูคำแนะนำในการติดตั้งจริง: [Running LLMs and VLMs on Jetson tutorial](https://developer.nvidia.com/blog/frontier-reasoning-reaches-the-edge/running-llms-and-vlms-on-jetson-tutorial/)เจาะลึกการใช้เทคนิคการปรับปรุงประสิทธิภาพด้วยคู่มือ Speculative Decoding: [Getting started with speculative decoding tutorial](https://developer.nvidia.com/blog/frontier-reasoning-reaches-the-edge/getting-started-with-speculative-decoding-tutorial/)การนำ AI ขั้นสูงมาสู่ขอบเขตเปิดโอกาสใหม่ๆ มากมาย ตั้งแต่ผู้ช่วยในห้องโดยสารรถยนต์ การตรวจจับความผิดปกติแบบเรียลไทม์ ไปจนถึงหุ่นยนต์ที่ทำงานในสภาพแวดล้อมที่ท้าทาย ทำให้ผู้เชี่ยวชาญสามารถทำงานได้อย่างมีประสิทธิภาพมากขึ้น และระบบสำคัญก็ยังคงทำงานได้แม้ในขณะที่การเชื่อมต่ออินเทอร์เน็ตมีจำกัดหรือขาดหายไปhttps://developer.nvidia.com/blog/frontier-reasoning-reaches-the-edge-how-to-deploy-and-optimize-models-on-nvidia-jetson/5 Comments 0 Shares 6K Views 0 Reviews -
ร่วมเป็นส่วนหนึ่งในการขับเคลื่อน "คลังความรู้สากล" ให้ยั่งยืน: การบริจาคของคุณมีค่าเป็น 3 เท่าในเดือนกันยายนนี้! 🚀
"การเข้าถึงความรู้ของมนุษย์ทั้งหมดอย่างทั่วถึง อยู่ในมือเราแล้ว หน้าที่ของเราคือการนำสิ่งที่ดีที่สุดในโลกมาสู่ลูกหลานของเรา" - Brewster Kahle, บรรณารักษ์ดิจิทัลของ Internet Archive
ทุกครั้งที่คุณค้นหาข้อมูลใน Wayback Machine หรือสำรวจคอลเลกชันต่างๆ ที่ Internet Archive คุณกำลังเข้าถึงห้องสมุดระดับโลกที่สร้างขึ้นเพื่อให้ความรู้เข้าถึงผู้เรียนที่อยากรู้อยากเห็นทั่วโลก 🌍
พันธกิจ "การเข้าถึงความรู้สากล" เป็นสิ่งที่สำคัญยิ่งกว่าแค่การสแกนหนังสือหรือการรวบรวมข้อมูลบนเว็บ แต่ยังต้องการเซิร์ฟเวอร์ พื้นที่จัดเก็บ พลังงาน ระบบหล่อเย็น และบุคลากรที่คอยสร้างและดูแลรักษาระบบของเรา โครงสร้างพื้นฐานเหล่านี้คือกระดูกสันหลังของห้องสมุดดิจิทัลของเรา
Internet Archive: ความเป็นอิสระที่มาพร้อมความรับผิดชอบ 💡
Internet Archive ให้บริการฟรีแก่ทุกคน ทุกที่ โดยไม่มีค่าใช้จ่าย เราไม่คิดค่าเข้าถึง ไม่ขายข้อมูลผู้ใช้ และไม่มีโฆษณา แทนที่จะพึ่งพาเทคโนโลยีจากภายนอก เราเลือกที่จะสร้างและดูแลรักษาระบบของเราเอง ความเป็นอิสระนี้ช่วยให้เราสามารถเก็บรักษาและให้บริการข้อมูลความรู้กว่า 210 เพตะไบต์แก่สาธารณะได้
อย่างไรก็ตาม นั่นหมายความว่าเราต้องรับผิดชอบในการดูแลให้โครงสร้างพื้นฐานเหล่านี้ทำงานได้อย่างต่อเนื่อง และความต้องการของเราก็เพิ่มสูงขึ้นอย่างรวดเร็ว
พลังแห่งการบริจาคซ้ำ: ยกระดับการสนับสนุนให้ทรงพลังยิ่งขึ้น! 💪
ในเดือนกันยายนนี้ คุณสามารถร่วมเป็นส่วนหนึ่งในการตอบสนองความท้าทายนี้ และทำให้การสนับสนุนของคุณมีค่าเป็นสามเท่า!
เมื่อคุณเริ่มต้นการบริจาคแบบประจำ (Recurring Donation) ตั้งแต่ 25 ดอลลาร์สหรัฐขึ้นไปในเดือนกันยายนนี้ การบริจาคครั้งแรกของคุณจะได้รับการจับคู่ 2:1 นั่นหมายความว่า:
- การบริจาค 25 ดอลลาร์สหรัฐต่อเดือน จะได้รับเงินสมทบเพิ่มเติมอีก 50 ดอลลาร์สหรัฐ รวมเป็น 75 ดอลลาร์สหรัฐ ในนามของคุณ
- การบริจาค 50 ดอลลาร์สหรัฐต่อเดือน จะกลายเป็น 150 ดอลลาร์สหรัฐ
- การบริจาค 100 ดอลลาร์สหรัฐต่อเดือน จะกลายเป็น 300 ดอลลาร์สหรัฐ
การบริจาคแบบประจำเป็นการสนับสนุนที่สม่ำเสมอและจำเป็นอย่างยิ่งต่อการดูแลโครงสร้างพื้นฐานของเราให้พร้อมใช้งานปีแล้วปีเล่า อันที่จริง Internet Archive ขับเคลื่อนด้วยการบริจาคโดยเฉลี่ยประมาณ 25 ดอลลาร์สหรัฐต่อครั้ง
ร่วมเป็นส่วนหนึ่งของ "Monthly Giving Circle" เพื่ออนาคตของความรู้ 🌟
เมื่อคุณเข้าร่วม "Monthly Giving Circle" คุณไม่ได้เป็นเพียงผู้สนับสนุนให้เซิร์ฟเวอร์ทำงานต่อไปเท่านั้น แต่คุณกำลังช่วยให้หนังสือยังคงอ่านได้ เว็บไซต์ยังคงเข้าถึงได้ และที่สำคัญที่สุดคือ คุณกำลังช่วยอนุรักษ์สิ่งที่ดีที่สุดที่เรามี เพื่อส่งต่อไปยังคนรุ่นหลัง
ร่วมเป็นส่วนหนึ่งของ Internet Archive "Monthly Giving Circle" ในเดือนกันยายนนี้ ด้วยการบริจาคแบบประจำตั้งแต่ 25 ดอลลาร์สหรัฐขึ้นไป แล้วการบริจาคครั้งแรกของคุณจะถูกเพิ่มมูลค่าเป็นสามเท่าผ่านการจับคู่ 2:1!
#InternetArchive #บริจาค #ความรู้ #เทคโนโลยี #การศึกษา
ขอบคุณ แหล่งข้อมูล
https://blog.archive.org/2026/09/01/keep-our-servers-running-your-recurring-donation-goes-3x-this-september/ร่วมเป็นส่วนหนึ่งในการขับเคลื่อน "คลังความรู้สากล" ให้ยั่งยืน: การบริจาคของคุณมีค่าเป็น 3 เท่าในเดือนกันยายนนี้! 🚀"การเข้าถึงความรู้ของมนุษย์ทั้งหมดอย่างทั่วถึง อยู่ในมือเราแล้ว หน้าที่ของเราคือการนำสิ่งที่ดีที่สุดในโลกมาสู่ลูกหลานของเรา" - Brewster Kahle, บรรณารักษ์ดิจิทัลของ Internet Archiveทุกครั้งที่คุณค้นหาข้อมูลใน Wayback Machine หรือสำรวจคอลเลกชันต่างๆ ที่ Internet Archive คุณกำลังเข้าถึงห้องสมุดระดับโลกที่สร้างขึ้นเพื่อให้ความรู้เข้าถึงผู้เรียนที่อยากรู้อยากเห็นทั่วโลก 🌍พันธกิจ "การเข้าถึงความรู้สากล" เป็นสิ่งที่สำคัญยิ่งกว่าแค่การสแกนหนังสือหรือการรวบรวมข้อมูลบนเว็บ แต่ยังต้องการเซิร์ฟเวอร์ พื้นที่จัดเก็บ พลังงาน ระบบหล่อเย็น และบุคลากรที่คอยสร้างและดูแลรักษาระบบของเรา โครงสร้างพื้นฐานเหล่านี้คือกระดูกสันหลังของห้องสมุดดิจิทัลของเราInternet Archive: ความเป็นอิสระที่มาพร้อมความรับผิดชอบ 💡Internet Archive ให้บริการฟรีแก่ทุกคน ทุกที่ โดยไม่มีค่าใช้จ่าย เราไม่คิดค่าเข้าถึง ไม่ขายข้อมูลผู้ใช้ และไม่มีโฆษณา แทนที่จะพึ่งพาเทคโนโลยีจากภายนอก เราเลือกที่จะสร้างและดูแลรักษาระบบของเราเอง ความเป็นอิสระนี้ช่วยให้เราสามารถเก็บรักษาและให้บริการข้อมูลความรู้กว่า 210 เพตะไบต์แก่สาธารณะได้อย่างไรก็ตาม นั่นหมายความว่าเราต้องรับผิดชอบในการดูแลให้โครงสร้างพื้นฐานเหล่านี้ทำงานได้อย่างต่อเนื่อง และความต้องการของเราก็เพิ่มสูงขึ้นอย่างรวดเร็วพลังแห่งการบริจาคซ้ำ: ยกระดับการสนับสนุนให้ทรงพลังยิ่งขึ้น! 💪ในเดือนกันยายนนี้ คุณสามารถร่วมเป็นส่วนหนึ่งในการตอบสนองความท้าทายนี้ และทำให้การสนับสนุนของคุณมีค่าเป็นสามเท่า!เมื่อคุณเริ่มต้นการบริจาคแบบประจำ (Recurring Donation) ตั้งแต่ 25 ดอลลาร์สหรัฐขึ้นไปในเดือนกันยายนนี้ การบริจาคครั้งแรกของคุณจะได้รับการจับคู่ 2:1 นั่นหมายความว่า:การบริจาค 25 ดอลลาร์สหรัฐต่อเดือน จะได้รับเงินสมทบเพิ่มเติมอีก 50 ดอลลาร์สหรัฐ รวมเป็น 75 ดอลลาร์สหรัฐ ในนามของคุณการบริจาค 50 ดอลลาร์สหรัฐต่อเดือน จะกลายเป็น 150 ดอลลาร์สหรัฐการบริจาค 100 ดอลลาร์สหรัฐต่อเดือน จะกลายเป็น 300 ดอลลาร์สหรัฐการบริจาคแบบประจำเป็นการสนับสนุนที่สม่ำเสมอและจำเป็นอย่างยิ่งต่อการดูแลโครงสร้างพื้นฐานของเราให้พร้อมใช้งานปีแล้วปีเล่า อันที่จริง Internet Archive ขับเคลื่อนด้วยการบริจาคโดยเฉลี่ยประมาณ 25 ดอลลาร์สหรัฐต่อครั้งร่วมเป็นส่วนหนึ่งของ "Monthly Giving Circle" เพื่ออนาคตของความรู้ 🌟เมื่อคุณเข้าร่วม "Monthly Giving Circle" คุณไม่ได้เป็นเพียงผู้สนับสนุนให้เซิร์ฟเวอร์ทำงานต่อไปเท่านั้น แต่คุณกำลังช่วยให้หนังสือยังคงอ่านได้ เว็บไซต์ยังคงเข้าถึงได้ และที่สำคัญที่สุดคือ คุณกำลังช่วยอนุรักษ์สิ่งที่ดีที่สุดที่เรามี เพื่อส่งต่อไปยังคนรุ่นหลังร่วมเป็นส่วนหนึ่งของ Internet Archive "Monthly Giving Circle" ในเดือนกันยายนนี้ ด้วยการบริจาคแบบประจำตั้งแต่ 25 ดอลลาร์สหรัฐขึ้นไป แล้วการบริจาคครั้งแรกของคุณจะถูกเพิ่มมูลค่าเป็นสามเท่าผ่านการจับคู่ 2:1!#InternetArchive #บริจาค #ความรู้ #เทคโนโลยี #การศึกษาhttps://blog.archive.org/2026/09/01/keep-our-servers-running-your-recurring-donation-goes-3x-this-september/7 Comments 0 Shares 6K Views 0 Reviews -
การสนับสนุนวารสารศาสตร์อิสระในยูเครน: บทบาทของ AI
ในยุคดิจิทัลที่ข่าวสารแพร่กระจายไปอย่างรวดเร็ว บทบาทของวารสารศาสตร์อิสระมีความสำคัญอย่างยิ่งในการให้ข้อมูลที่ถูกต้องและเป็นกลางแก่สาธารณชน โดยเฉพาะอย่างยิ่งในสถานการณ์ที่ซับซ้อนอย่างในยูเครน การเข้าถึงข้อมูลที่น่าเชื่อถือกลายเป็นสิ่งจำเป็นสำหรับประชาชนและผู้คนทั่วโลก
OpenAI ตระหนักถึงความสำคัญนี้ จึงได้ริเริ่มโครงการเพื่อสนับสนุนวารสารศาสตร์อิสระในยูเครน โดยใช้เทคโนโลยี AI เข้ามาช่วยเสริมศักยภาพในการทำงานของนักข่าว และยกระดับการเข้าถึงข้อมูลข่าวสารให้ดียิ่งขึ้น
ความท้าทายของวารสารศาสตร์ในสถานการณ์ความขัดแย้ง
นักข่าวในพื้นที่ความขัดแย้งต้องเผชิญกับความท้าทายมากมาย ไม่ว่าจะเป็น:
- การเข้าถึงข้อมูล: การตรวจสอบข้อเท็จจริง (Fact-checking) และการรวบรวมข้อมูลที่ถูกต้องอาจเป็นเรื่องยากลำบากภายใต้ข้อจำกัดด้านความปลอดภัยและการเข้าถึง
- ปริมาณข้อมูลมหาศาล: ข่าวสารและข้อมูลที่หลั่งไหลเข้ามามีจำนวนมาก การคัดกรองและวิเคราะห์ข้อมูลให้เป็นประเด็นสำคัญต้องใช้เวลาและความเชี่ยวชาญ
- การแปลภาษา: การสื่อสารข้ามพรมแดนจำเป็นต้องมีการแปลภาษาที่ถูกต้องและรวดเร็ว เพื่อให้ข้อมูลเข้าถึงผู้คนในวงกว้าง
- ความปลอดภัยของนักข่าว: การทำงานในพื้นที่เสี่ยงภัยทำให้นักข่าวต้องคำนึงถึงความปลอดภัยเป็นอันดับแรก
AI กับการสนับสนุนวารสารศาสตร์
OpenAI เล็งเห็นถึงศักยภาพของ AI ในการเข้ามาช่วยบรรเทาความท้าทายเหล่านี้:
1. การวิเคราะห์และสรุปข้อมูล 🔍
AI สามารถช่วยประมวลผลเอกสารจำนวนมาก แปลงานวิจัย หรือแม้กระทั่งสรุปรายงานข่าวที่ยาวเหยียดให้เป็นใจความสำคัญได้ ทำให้นักข่าวสามารถประหยัดเวลาและมุ่งเน้นไปที่การวิเคราะห์เชิงลึกและการรายงานข่าวที่สำคัญได้มากขึ้น
2. การตรวจสอบข้อเท็จจริงเบื้องต้น ✅
เครื่องมือ AI สามารถช่วยในการค้นหาแหล่งข้อมูลที่เกี่ยวข้อง ตรวจสอบความสอดคล้องของข้อมูลจากหลายแหล่ง และระบุข้อมูลที่อาจเป็นเท็จเบื้องต้น ซึ่งจะเป็นเครื่องมือเสริมอันทรงพลังให้กับนักข่าวในการทำงานตรวจสอบข้อเท็จจริง
3. การแปลภาษาที่รวดเร็วและแม่นยำ 🌍
AI ด้านการแปลภาษาช่วยให้นักข่าวสามารถเข้าถึงข้อมูลจากแหล่งข่าวต่างประเทศ หรือสื่อสารกับผู้คนในท้องถิ่นได้อย่างมีประสิทธิภาพมากขึ้น ทำให้การรายงานข่าวครอบคลุมและรอบด้าน
4. การสร้างเนื้อหาเบื้องต้น ✍️
AI สามารถช่วยร่างโครงสร้างบทความ สร้างคำอธิบายสั้นๆ หรือแม้กระทั่งช่วยเขียนข่าวตามข้อเท็จจริงที่กำหนดไว้เบื้องต้นได้ ซึ่งจะช่วยลดภาระงานเขียน และทำให้นักข่าวมีเวลามากขึ้นในการลงพื้นที่สัมภาษณ์และหาข้อมูลเชิงลึก
ความร่วมมือเพื่ออนาคตของวารสารศาสตร์
OpenAI ได้ร่วมมือกับองค์กรและนักข่าวในยูเครน เพื่อพัฒนาและทดสอบเครื่องมือ AI ที่เหมาะสมกับการใช้งานจริงในสภาพแวดล้อมที่ซับซ้อนนี้ การผลักดันนี้ไม่เพียงแต่เป็นการสนับสนุนวารสารศาสตร์อิสระ แต่ยังเป็นการสร้างต้นแบบในการใช้ AI เพื่อประโยชน์สาธารณะในสถานการณ์วิกฤตอีกด้วย
การสนับสนุนวารสารศาสตร์อิสระในยูเครนด้วยเทคโนโลยี AI ถือเป็นก้าวสำคัญในการสร้างความเข้มแข็งให้กับระบบนิเวศข่าวสาร และทำให้ประชาชนสามารถเข้าถึงข้อมูลที่ถูกต้องและเชื่อถือได้ ท่ามกลางความท้าทายที่ถาโถมเข้ามา
ขอบคุณ แหล่งข้อมูล
https://openai.com/index/supporting-independent-journalism-in-ukraineการสนับสนุนวารสารศาสตร์อิสระในยูเครน: บทบาทของ AIในยุคดิจิทัลที่ข่าวสารแพร่กระจายไปอย่างรวดเร็ว บทบาทของวารสารศาสตร์อิสระมีความสำคัญอย่างยิ่งในการให้ข้อมูลที่ถูกต้องและเป็นกลางแก่สาธารณชน โดยเฉพาะอย่างยิ่งในสถานการณ์ที่ซับซ้อนอย่างในยูเครน การเข้าถึงข้อมูลที่น่าเชื่อถือกลายเป็นสิ่งจำเป็นสำหรับประชาชนและผู้คนทั่วโลกOpenAI ตระหนักถึงความสำคัญนี้ จึงได้ริเริ่มโครงการเพื่อสนับสนุนวารสารศาสตร์อิสระในยูเครน โดยใช้เทคโนโลยี AI เข้ามาช่วยเสริมศักยภาพในการทำงานของนักข่าว และยกระดับการเข้าถึงข้อมูลข่าวสารให้ดียิ่งขึ้นความท้าทายของวารสารศาสตร์ในสถานการณ์ความขัดแย้งนักข่าวในพื้นที่ความขัดแย้งต้องเผชิญกับความท้าทายมากมาย ไม่ว่าจะเป็น:การเข้าถึงข้อมูล: การตรวจสอบข้อเท็จจริง (Fact-checking) และการรวบรวมข้อมูลที่ถูกต้องอาจเป็นเรื่องยากลำบากภายใต้ข้อจำกัดด้านความปลอดภัยและการเข้าถึงปริมาณข้อมูลมหาศาล: ข่าวสารและข้อมูลที่หลั่งไหลเข้ามามีจำนวนมาก การคัดกรองและวิเคราะห์ข้อมูลให้เป็นประเด็นสำคัญต้องใช้เวลาและความเชี่ยวชาญการแปลภาษา: การสื่อสารข้ามพรมแดนจำเป็นต้องมีการแปลภาษาที่ถูกต้องและรวดเร็ว เพื่อให้ข้อมูลเข้าถึงผู้คนในวงกว้างความปลอดภัยของนักข่าว: การทำงานในพื้นที่เสี่ยงภัยทำให้นักข่าวต้องคำนึงถึงความปลอดภัยเป็นอันดับแรกAI กับการสนับสนุนวารสารศาสตร์OpenAI เล็งเห็นถึงศักยภาพของ AI ในการเข้ามาช่วยบรรเทาความท้าทายเหล่านี้:1. การวิเคราะห์และสรุปข้อมูล 🔍AI สามารถช่วยประมวลผลเอกสารจำนวนมาก แปลงานวิจัย หรือแม้กระทั่งสรุปรายงานข่าวที่ยาวเหยียดให้เป็นใจความสำคัญได้ ทำให้นักข่าวสามารถประหยัดเวลาและมุ่งเน้นไปที่การวิเคราะห์เชิงลึกและการรายงานข่าวที่สำคัญได้มากขึ้น2. การตรวจสอบข้อเท็จจริงเบื้องต้น ✅เครื่องมือ AI สามารถช่วยในการค้นหาแหล่งข้อมูลที่เกี่ยวข้อง ตรวจสอบความสอดคล้องของข้อมูลจากหลายแหล่ง และระบุข้อมูลที่อาจเป็นเท็จเบื้องต้น ซึ่งจะเป็นเครื่องมือเสริมอันทรงพลังให้กับนักข่าวในการทำงานตรวจสอบข้อเท็จจริง3. การแปลภาษาที่รวดเร็วและแม่นยำ 🌍AI ด้านการแปลภาษาช่วยให้นักข่าวสามารถเข้าถึงข้อมูลจากแหล่งข่าวต่างประเทศ หรือสื่อสารกับผู้คนในท้องถิ่นได้อย่างมีประสิทธิภาพมากขึ้น ทำให้การรายงานข่าวครอบคลุมและรอบด้าน4. การสร้างเนื้อหาเบื้องต้น ✍️AI สามารถช่วยร่างโครงสร้างบทความ สร้างคำอธิบายสั้นๆ หรือแม้กระทั่งช่วยเขียนข่าวตามข้อเท็จจริงที่กำหนดไว้เบื้องต้นได้ ซึ่งจะช่วยลดภาระงานเขียน และทำให้นักข่าวมีเวลามากขึ้นในการลงพื้นที่สัมภาษณ์และหาข้อมูลเชิงลึกความร่วมมือเพื่ออนาคตของวารสารศาสตร์OpenAI ได้ร่วมมือกับองค์กรและนักข่าวในยูเครน เพื่อพัฒนาและทดสอบเครื่องมือ AI ที่เหมาะสมกับการใช้งานจริงในสภาพแวดล้อมที่ซับซ้อนนี้ การผลักดันนี้ไม่เพียงแต่เป็นการสนับสนุนวารสารศาสตร์อิสระ แต่ยังเป็นการสร้างต้นแบบในการใช้ AI เพื่อประโยชน์สาธารณะในสถานการณ์วิกฤตอีกด้วยการสนับสนุนวารสารศาสตร์อิสระในยูเครนด้วยเทคโนโลยี AI ถือเป็นก้าวสำคัญในการสร้างความเข้มแข็งให้กับระบบนิเวศข่าวสาร และทำให้ประชาชนสามารถเข้าถึงข้อมูลที่ถูกต้องและเชื่อถือได้ ท่ามกลางความท้าทายที่ถาโถมเข้ามาhttps://openai.com/index/supporting-independent-journalism-in-ukraine0 Comments 0 Shares 6K Views 0 Reviews -
Funes: สร้าง "ความทรงจำ" ให้กับ AI Coding Agent ของคุณเอง
ในโลกของการพัฒนาซอฟต์แวร์ที่ AI Coding Agent เข้ามามีบทบาทสำคัญมากขึ้นเรื่อยๆ การที่ Agent เหล่านี้จะสามารถทำงานได้อย่างมีประสิทธิภาพสูงสุดนั้น จำเป็นต้องมี "ความทรงจำ" ที่ดี เพื่อให้สามารถอ้างอิงข้อมูลในอดีต หรือเข้าใจบริบทของการทำงานที่ผ่านมาได้ "Funes" คือเครื่องมือที่จะเข้ามาตอบโจทย์นี้ โดยทำหน้าที่เป็นชั้นหน่วยความจำที่ทนทาน (Durable Memory Layer) สำหรับ Coding Agent ของคุณ เพื่อให้พวกมันสามารถจดจำและนำข้อมูลที่เคยประมวลผลไปใช้ได้อย่างชาญฉลาด
ทำไม Coding Agent ถึงต้องการ "ความทรงจำ"?
เมื่อ Coding Agent ทำงาน พวกมันจะค้นหาโค้ด ลองใช้วิธีการต่างๆ พบข้อผิดพลาด อ่านเอกสาร และปรับเปลี่ยนทิศทางการทำงาน ซึ่งทั้งหมดนี้จะทิ้งร่องรอย (Traces) หรือบันทึกการทำงานไว้มากมาย ร่องรอยเหล่านี้ไม่ใช่แค่ข้อมูลว่าอะไรเปลี่ยนแปลงไป แต่ยังบอกถึง "เหตุผล" เบื้องหลังการเปลี่ยนแปลงนั้นด้วย
อย่างไรก็ตาม บันทึกการทำงานเหล่านี้เป็นเพียง "ศักยภาพ" ของความทรงจำเท่านั้น หากไม่มีการจัดการที่ดี เช่น การจัดทำดัชนี (Indexing) การดึงข้อมูล (Retrieval) การจัดลำดับ (Ranking) และการอ้างอิงแหล่งที่มาที่ชัดเจน (Provenance) การจะค้นหาข้อมูลที่ต้องการ เช่น "ทำไมเราถึงเลิกใช้ Streaming Parser?" จากบันทึกนับหมื่นเทิร์น ก็แทบจะเป็นไปไม่ได้
Funes คืออะไร และทำงานอย่างไร?
Funes ถูกออกแบบมาเพื่อแก้ปัญหานี้ โดยเป็นชั้นหน่วยความจำที่สร้างขึ้นจากเซสชันการทำงานของ Agent ที่มีอยู่แล้วบนเครื่องของคุณ โดยทำงานแบบ Local และผสานรวมเข้ากับ Workflow ปกติของ Agent ได้ง่ายๆ ด้วยคำสั่งเดียว
การติดตั้งและเพิ่ม Funes ให้กับ Agent:
- ติดตั้ง Funes:
pip install funes- เพิ่ม Funes ให้กับ Agent:
funes add --agentเมื่อรันคำสั่งนี้ Funes จะสร้าง Index แรกให้กับ Agent, เพิ่มเครื่องมือ Recall และ Get, และติดตั้งระบบอัตโนมัติที่คอย Index ทุกเทิร์นที่เสร็จสมบูรณ์ การ Index เป็นแบบ Incremental หมายความว่า การรันแต่ละครั้งจะเพิ่มเทิร์นใหม่ๆ เข้าไป แทนที่จะต้อง Embed ประวัติทั้งหมดใหม่ทั้งหมด เนื้อหาเก่าๆ ที่มีความลึกสามารถทยอย Backfill ได้
หลังจากนั้น เมื่อ Agent ต้องการอ้างอิงการตัดสินใจในอดีต, เหตุผลเบื้องหลัง, หรือสิ่งที่เคยค้นพบ มันสามารถเรียกใช้ "Recall" ได้เอง โดยที่คุณไม่จำเป็นต้องจำเซสชันเก่า หรือคัดลอกบริบทไปวางในเซสชันใหม่
การทำงานของ Recall
เมื่อ Funes ถูกเพิ่มเข้าไป การ Recall จะเกิดขึ้นภายในบทสนทนา Agent จะเรียกใช้หน่วยความจำของตนเองโดยอัตโนมัติ และระบุเซสชันที่ใช้ในการให้คำตอบ
- Recall จะคืนค่าข้อความต้นฉบับ ไม่ใช่บทสรุป และแสดงที่มาที่ชัดเจน (Agent, Timestamp, Session, และ Turn)
- ผลลัพธ์แต่ละรายการจะมาพร้อมคำสั่ง Get ซึ่งจะเปิด Turn เต็มๆ และบริบทโดยรอบ
เบื้องหลัง Funes ใช้ Pipeline ที่ทำงานแบบ Deterministic ในการ Parse Trace ที่รองรับให้อยู่ในรูปแบบ Turn-and-Block ที่เหมือนกัน, ทำการ Chunk ข้อมูล, Embed ด้วย Local Model ที่ถูกปักหมุดไว้, และเขียนลงใน Lance Dataset แบบ Local
คุณสมบัติสำคัญของ Funes
Funes มีคุณสมบัติที่น่าสนใจ 3 ประการ:
- หน่วยความจำเดียวใช้ได้กับหลาย Agent: Claude Code, Codex, pi, และ Hermes สามารถเขียนข้อมูลไปยัง Shape เดียวกันได้ ทำให้ Recall สามารถครอบคลุมประวัติการทำงานของ Agent เหล่านี้ทั้งหมด และแต่ละผลลัพธ์จะบอกได้ว่า Agent ใดเป็นผู้สร้าง
- รักษาหลักฐานดิบไว้: ข้อมูลจะไม่ถูกสรุปหรือกลั่นกรองเป็นข้อเท็จจริงทันทีที่เขียน ทำให้สามารถย้อนกลับไปยัง Turn ที่สร้างข้อมูลนั้นๆ ได้เสมอ
- Recall ทำงานแบบ Local เป็นค่าเริ่มต้น: ไม่จำเป็นต้องมีบัญชีหรือ Hub Repository การประมวลผล Embedding และ Reranking จะทำบนเครื่องของคุณเอง Agent ของคุณเป็นผู้ดำเนินการ Reasoning เอง
เมื่อความทรงจำเดินทางข้ามเครื่อง: การใช้งานร่วมกับ Hugging Face Hub
Funes ไม่เพียงทำงานบนเครื่องเดียวได้ แต่ยังสามารถทำให้หน่วยความจำของคุณเดินทางไปกับคุณได้ โดยการผูก (Bind) เข้ากับ Hugging Face Dataset ที่คุณเป็นเจ้าของ (โดยค่าเริ่มต้นจะเป็น Private)
เมื่อคุณต้องการให้หน่วยความจำตามติดการทำงานของคุณ:
funes add --agent --memoryคำสั่งนี้จะทำการ Publish หน่วยความจำปัจจุบันของคุณไปยัง Dataset ที่ระบุ และ Funes จะคอยอัปเดตอย่างต่อเนื่อง โดย Index ทุกเทิร์นแบบ Local และ Publish เมื่อจบเซสชัน Agent จะทำการ Recall จากหน่วยความจำนี้ตลอดการทำงาน
ความปลอดภัย: ก่อนที่ข้อมูลจะถูกส่งไปยัง Hub, Funes จะทำการ Redact ข้อมูล Credentials ในระหว่างการ Index และสแกนซ้ำอีกครั้งเพื่อลบข้อมูลที่อาจเป็นความลับ
เมื่อ Agent อ่านหน่วยความจำจากระยะไกล Funes จะ Cache ไฟล์ Dataset ไว้บนเครื่อง ทำให้การ Query รวดเร็วเหมือนทำงานแบบ Local โดย Hub จะทำหน้าที่จัดการเรื่อง Ownership, Access Control, Versioning, และ Distribution
Ask: สอบถามหน่วยความจำด้วยตนเอง
นอกจากการให้ Agent เรียกใช้ Recall เองแล้ว คุณยังสามารถใช้คำสั่ง
askเพื่อสอบถามหน่วยความจำได้โดยตรงfunes ask --memory "คำถามของคุณ"หรือสอบถามจากหน่วยความจำที่เผยแพร่แล้ว เช่น หน่วยความจำของการพัฒนา Funes เพื่อทำความเข้าใจว่าทำไม Funes ถึงทำงานในลักษณะนี้ โดยไม่ต้องสร้างหน่วยความจำของคุณเอง
funes askจะทำการ Recall ข้อความที่เกี่ยวข้อง, ส่งให้ Coding Agent, และคืนคำตอบที่อ้างอิงแหล่งที่มาได้อย่างชัดเจน หากข้อความที่ Recall ได้ไม่เพียงพอต่อการตอบ Agent จะแจ้งให้ทราบ คุณสามารถลองปรับเปลี่ยนคำถาม หรือเพิ่ม Funes ให้กับ Agent เพื่อให้มันสามารถค้นหาในหน่วยความจำแบบวนซ้ำได้สลับ Agent โดยไม่เสีย "เส้นเรื่อง"
หน่วยความจำที่เผยแพร่นั้นไม่ได้ผูกติดกับ Agent หรือ Model ที่สร้างมัน คุณสามารถเริ่มทำงานใน Claude Code, กลับมาทำต่อใน Codex สัปดาห์หน้า, และ Agent ที่สองก็จะสามารถ Recall เหตุผลการทำงานของ Agent แรกได้ หรือใช้ pi กับ Local Model แล้วกลับมาใช้ Claude ได้เช่นกัน
ประโยชน์ของหน่วยความจำที่แชร์ได้:
- ข้ามเครื่อง: ผูก Agent แต่ละตัวเข้ากับหน่วยความจำเดียว และ Recall ประวัติจาก Host ใดก็ได้ที่คุณใช้งาน
- ข้ามทีม: สมาชิกใหม่ในทีมสามารถเข้าถึงการตัดสินใจหลายเดือนได้ตั้งแต่วันแรก รวมถึงข้อผิดพลาดและเหตุผลที่อาจไม่ได้ถูกรวมใน Pull Request
- คู่ขนานกับ Open Source Project: ผู้ดูแลโปรเจกต์สามารถเผยแพร่เซสชันเบื้องหลัง Release ต่างๆ ได้ ทำให้เหมือนมี "CLAUDE.md" ที่ค้นหาได้ ซึ่งเก็บประวัติความเป็นมาของโปรเจกต์ แทนที่จะเป็นหน้าเว็บที่ต้องคอยอัปเดตอยู่เสมอ
หน่วยความจำที่เผยแพร่จะมี Dataset Card และ Tag ของ Funes ทำให้สามารถจดจำและค้นหาได้บน Hub Funes เพิ่ม "Open Working Memory" เข้ามาใน Hub ซึ่งเก็บการตัดสินใจ, แนวทางที่ล้มเหลว, และเหตุผลเบื้องหลังโปรเจกต์ ที่ Agent อื่นสามารถ Query ได้ และสามารถ Trace กลับไปยังเซสชันที่สร้างมันขึ้นมาได้
วิธีที่ถูกที่สุดในการหลุดพ้นจากเซสชันยาวๆ
เซสชันการทำงานที่ยาวนานมักทำให้การประมวลผลแต่ละเทิร์นมีค่าใช้จ่ายสูงกว่าการทำงานใหม่ทั้งหมด คำตอบทั่วไปคือการปล่อยให้ Agent ทำการ Compact และดำเนินการต่อ หรือเขียน Handoff แล้วเริ่มต้นใหม่ Funes เสนอทางเลือกที่สามคือ "Recall"
จากการทดสอบ Handoff-vs-Recall Benchmark พบว่า Recall เป็นวิธีที่ ถูกที่สุด ในการจัดการเซสชันยาวๆ โดยถูกกว่าการเขียน Handoff ถึง 4-8 เท่า เพราะ Recall จะคืนค่า Passage ต้นฉบับ ทำให้ข้อมูลสำคัญไม่สูญหายไปกับการสรุป
หยุดการเริ่มต้นจากศูนย์
"การคิดคือการลืมความแตกต่าง, การสรุป, การสร้างนามธรรม" – Jorge Luis Borges, Funes the Memorious
Agent ของคุณได้เขียนบันทึกการทำงานไว้แล้ว Funes ที่อยู่ใน GitHub repository นี้ เพียงแค่คำสั่งเดียว ก็สามารถเปลี่ยนบันทึกนั้นให้กลายเป็น "ความทรงจำ" ที่ Agent ตัวต่อไปสามารถอ่านได้ ไม่ว่าคุณจะใช้งานบนเครื่องใดก็ตาม Funes สร้างขึ้นบนพื้นฐานของ Open Source โดยใช้ประโยชน์จาก Embedding Model, Lance Datasets, และ Hub สำหรับ Caching และ Content-deduplication
Funes เป็น Open Source เช่นกัน คุณสามารถเปิด Issue เพื่อแจ้งปัญหา หรือเสนอแนะ Agent ที่ต้องการให้รองรับได้
#AI #CodingAgent #OpenSource #Memory #HuggingFace
ขอบคุณ แหล่งข้อมูล
https://huggingface.co/blog/funesFunes: สร้าง "ความทรงจำ" ให้กับ AI Coding Agent ของคุณเองในโลกของการพัฒนาซอฟต์แวร์ที่ AI Coding Agent เข้ามามีบทบาทสำคัญมากขึ้นเรื่อยๆ การที่ Agent เหล่านี้จะสามารถทำงานได้อย่างมีประสิทธิภาพสูงสุดนั้น จำเป็นต้องมี "ความทรงจำ" ที่ดี เพื่อให้สามารถอ้างอิงข้อมูลในอดีต หรือเข้าใจบริบทของการทำงานที่ผ่านมาได้ "Funes" คือเครื่องมือที่จะเข้ามาตอบโจทย์นี้ โดยทำหน้าที่เป็นชั้นหน่วยความจำที่ทนทาน (Durable Memory Layer) สำหรับ Coding Agent ของคุณ เพื่อให้พวกมันสามารถจดจำและนำข้อมูลที่เคยประมวลผลไปใช้ได้อย่างชาญฉลาดทำไม Coding Agent ถึงต้องการ "ความทรงจำ"?เมื่อ Coding Agent ทำงาน พวกมันจะค้นหาโค้ด ลองใช้วิธีการต่างๆ พบข้อผิดพลาด อ่านเอกสาร และปรับเปลี่ยนทิศทางการทำงาน ซึ่งทั้งหมดนี้จะทิ้งร่องรอย (Traces) หรือบันทึกการทำงานไว้มากมาย ร่องรอยเหล่านี้ไม่ใช่แค่ข้อมูลว่าอะไรเปลี่ยนแปลงไป แต่ยังบอกถึง "เหตุผล" เบื้องหลังการเปลี่ยนแปลงนั้นด้วยอย่างไรก็ตาม บันทึกการทำงานเหล่านี้เป็นเพียง "ศักยภาพ" ของความทรงจำเท่านั้น หากไม่มีการจัดการที่ดี เช่น การจัดทำดัชนี (Indexing) การดึงข้อมูล (Retrieval) การจัดลำดับ (Ranking) และการอ้างอิงแหล่งที่มาที่ชัดเจน (Provenance) การจะค้นหาข้อมูลที่ต้องการ เช่น "ทำไมเราถึงเลิกใช้ Streaming Parser?" จากบันทึกนับหมื่นเทิร์น ก็แทบจะเป็นไปไม่ได้Funes คืออะไร และทำงานอย่างไร?Funes ถูกออกแบบมาเพื่อแก้ปัญหานี้ โดยเป็นชั้นหน่วยความจำที่สร้างขึ้นจากเซสชันการทำงานของ Agent ที่มีอยู่แล้วบนเครื่องของคุณ โดยทำงานแบบ Local และผสานรวมเข้ากับ Workflow ปกติของ Agent ได้ง่ายๆ ด้วยคำสั่งเดียวการติดตั้งและเพิ่ม Funes ให้กับ Agent:ติดตั้ง Funes: pip install funesเพิ่ม Funes ให้กับ Agent: funes add --agent เมื่อรันคำสั่งนี้ Funes จะสร้าง Index แรกให้กับ Agent, เพิ่มเครื่องมือ Recall และ Get, และติดตั้งระบบอัตโนมัติที่คอย Index ทุกเทิร์นที่เสร็จสมบูรณ์ การ Index เป็นแบบ Incremental หมายความว่า การรันแต่ละครั้งจะเพิ่มเทิร์นใหม่ๆ เข้าไป แทนที่จะต้อง Embed ประวัติทั้งหมดใหม่ทั้งหมด เนื้อหาเก่าๆ ที่มีความลึกสามารถทยอย Backfill ได้หลังจากนั้น เมื่อ Agent ต้องการอ้างอิงการตัดสินใจในอดีต, เหตุผลเบื้องหลัง, หรือสิ่งที่เคยค้นพบ มันสามารถเรียกใช้ "Recall" ได้เอง โดยที่คุณไม่จำเป็นต้องจำเซสชันเก่า หรือคัดลอกบริบทไปวางในเซสชันใหม่การทำงานของ Recallเมื่อ Funes ถูกเพิ่มเข้าไป การ Recall จะเกิดขึ้นภายในบทสนทนา Agent จะเรียกใช้หน่วยความจำของตนเองโดยอัตโนมัติ และระบุเซสชันที่ใช้ในการให้คำตอบRecall จะคืนค่าข้อความต้นฉบับ ไม่ใช่บทสรุป และแสดงที่มาที่ชัดเจน (Agent, Timestamp, Session, และ Turn)ผลลัพธ์แต่ละรายการจะมาพร้อมคำสั่ง Get ซึ่งจะเปิด Turn เต็มๆ และบริบทโดยรอบเบื้องหลัง Funes ใช้ Pipeline ที่ทำงานแบบ Deterministic ในการ Parse Trace ที่รองรับให้อยู่ในรูปแบบ Turn-and-Block ที่เหมือนกัน, ทำการ Chunk ข้อมูล, Embed ด้วย Local Model ที่ถูกปักหมุดไว้, และเขียนลงใน Lance Dataset แบบ Localคุณสมบัติสำคัญของ FunesFunes มีคุณสมบัติที่น่าสนใจ 3 ประการ:หน่วยความจำเดียวใช้ได้กับหลาย Agent: Claude Code, Codex, pi, และ Hermes สามารถเขียนข้อมูลไปยัง Shape เดียวกันได้ ทำให้ Recall สามารถครอบคลุมประวัติการทำงานของ Agent เหล่านี้ทั้งหมด และแต่ละผลลัพธ์จะบอกได้ว่า Agent ใดเป็นผู้สร้างรักษาหลักฐานดิบไว้: ข้อมูลจะไม่ถูกสรุปหรือกลั่นกรองเป็นข้อเท็จจริงทันทีที่เขียน ทำให้สามารถย้อนกลับไปยัง Turn ที่สร้างข้อมูลนั้นๆ ได้เสมอRecall ทำงานแบบ Local เป็นค่าเริ่มต้น: ไม่จำเป็นต้องมีบัญชีหรือ Hub Repository การประมวลผล Embedding และ Reranking จะทำบนเครื่องของคุณเอง Agent ของคุณเป็นผู้ดำเนินการ Reasoning เองเมื่อความทรงจำเดินทางข้ามเครื่อง: การใช้งานร่วมกับ Hugging Face HubFunes ไม่เพียงทำงานบนเครื่องเดียวได้ แต่ยังสามารถทำให้หน่วยความจำของคุณเดินทางไปกับคุณได้ โดยการผูก (Bind) เข้ากับ Hugging Face Dataset ที่คุณเป็นเจ้าของ (โดยค่าเริ่มต้นจะเป็น Private)เมื่อคุณต้องการให้หน่วยความจำตามติดการทำงานของคุณ:funes add --agent --memory คำสั่งนี้จะทำการ Publish หน่วยความจำปัจจุบันของคุณไปยัง Dataset ที่ระบุ และ Funes จะคอยอัปเดตอย่างต่อเนื่อง โดย Index ทุกเทิร์นแบบ Local และ Publish เมื่อจบเซสชัน Agent จะทำการ Recall จากหน่วยความจำนี้ตลอดการทำงานความปลอดภัย: ก่อนที่ข้อมูลจะถูกส่งไปยัง Hub, Funes จะทำการ Redact ข้อมูล Credentials ในระหว่างการ Index และสแกนซ้ำอีกครั้งเพื่อลบข้อมูลที่อาจเป็นความลับเมื่อ Agent อ่านหน่วยความจำจากระยะไกล Funes จะ Cache ไฟล์ Dataset ไว้บนเครื่อง ทำให้การ Query รวดเร็วเหมือนทำงานแบบ Local โดย Hub จะทำหน้าที่จัดการเรื่อง Ownership, Access Control, Versioning, และ DistributionAsk: สอบถามหน่วยความจำด้วยตนเองนอกจากการให้ Agent เรียกใช้ Recall เองแล้ว คุณยังสามารถใช้คำสั่ง ask เพื่อสอบถามหน่วยความจำได้โดยตรงfunes ask --memory "คำถามของคุณ"หรือสอบถามจากหน่วยความจำที่เผยแพร่แล้ว เช่น หน่วยความจำของการพัฒนา Funes เพื่อทำความเข้าใจว่าทำไม Funes ถึงทำงานในลักษณะนี้ โดยไม่ต้องสร้างหน่วยความจำของคุณเองfunes ask จะทำการ Recall ข้อความที่เกี่ยวข้อง, ส่งให้ Coding Agent, และคืนคำตอบที่อ้างอิงแหล่งที่มาได้อย่างชัดเจน หากข้อความที่ Recall ได้ไม่เพียงพอต่อการตอบ Agent จะแจ้งให้ทราบ คุณสามารถลองปรับเปลี่ยนคำถาม หรือเพิ่ม Funes ให้กับ Agent เพื่อให้มันสามารถค้นหาในหน่วยความจำแบบวนซ้ำได้สลับ Agent โดยไม่เสีย "เส้นเรื่อง"หน่วยความจำที่เผยแพร่นั้นไม่ได้ผูกติดกับ Agent หรือ Model ที่สร้างมัน คุณสามารถเริ่มทำงานใน Claude Code, กลับมาทำต่อใน Codex สัปดาห์หน้า, และ Agent ที่สองก็จะสามารถ Recall เหตุผลการทำงานของ Agent แรกได้ หรือใช้ pi กับ Local Model แล้วกลับมาใช้ Claude ได้เช่นกันประโยชน์ของหน่วยความจำที่แชร์ได้:ข้ามเครื่อง: ผูก Agent แต่ละตัวเข้ากับหน่วยความจำเดียว และ Recall ประวัติจาก Host ใดก็ได้ที่คุณใช้งานข้ามทีม: สมาชิกใหม่ในทีมสามารถเข้าถึงการตัดสินใจหลายเดือนได้ตั้งแต่วันแรก รวมถึงข้อผิดพลาดและเหตุผลที่อาจไม่ได้ถูกรวมใน Pull Requestคู่ขนานกับ Open Source Project: ผู้ดูแลโปรเจกต์สามารถเผยแพร่เซสชันเบื้องหลัง Release ต่างๆ ได้ ทำให้เหมือนมี "CLAUDE.md" ที่ค้นหาได้ ซึ่งเก็บประวัติความเป็นมาของโปรเจกต์ แทนที่จะเป็นหน้าเว็บที่ต้องคอยอัปเดตอยู่เสมอหน่วยความจำที่เผยแพร่จะมี Dataset Card และ Tag ของ Funes ทำให้สามารถจดจำและค้นหาได้บน Hub Funes เพิ่ม "Open Working Memory" เข้ามาใน Hub ซึ่งเก็บการตัดสินใจ, แนวทางที่ล้มเหลว, และเหตุผลเบื้องหลังโปรเจกต์ ที่ Agent อื่นสามารถ Query ได้ และสามารถ Trace กลับไปยังเซสชันที่สร้างมันขึ้นมาได้วิธีที่ถูกที่สุดในการหลุดพ้นจากเซสชันยาวๆเซสชันการทำงานที่ยาวนานมักทำให้การประมวลผลแต่ละเทิร์นมีค่าใช้จ่ายสูงกว่าการทำงานใหม่ทั้งหมด คำตอบทั่วไปคือการปล่อยให้ Agent ทำการ Compact และดำเนินการต่อ หรือเขียน Handoff แล้วเริ่มต้นใหม่ Funes เสนอทางเลือกที่สามคือ "Recall"จากการทดสอบ Handoff-vs-Recall Benchmark พบว่า Recall เป็นวิธีที่ ถูกที่สุด ในการจัดการเซสชันยาวๆ โดยถูกกว่าการเขียน Handoff ถึง 4-8 เท่า เพราะ Recall จะคืนค่า Passage ต้นฉบับ ทำให้ข้อมูลสำคัญไม่สูญหายไปกับการสรุปหยุดการเริ่มต้นจากศูนย์"การคิดคือการลืมความแตกต่าง, การสรุป, การสร้างนามธรรม" – Jorge Luis Borges, Funes the MemoriousAgent ของคุณได้เขียนบันทึกการทำงานไว้แล้ว Funes ที่อยู่ใน GitHub repository นี้ เพียงแค่คำสั่งเดียว ก็สามารถเปลี่ยนบันทึกนั้นให้กลายเป็น "ความทรงจำ" ที่ Agent ตัวต่อไปสามารถอ่านได้ ไม่ว่าคุณจะใช้งานบนเครื่องใดก็ตาม Funes สร้างขึ้นบนพื้นฐานของ Open Source โดยใช้ประโยชน์จาก Embedding Model, Lance Datasets, และ Hub สำหรับ Caching และ Content-deduplicationFunes เป็น Open Source เช่นกัน คุณสามารถเปิด Issue เพื่อแจ้งปัญหา หรือเสนอแนะ Agent ที่ต้องการให้รองรับได้#AI #CodingAgent #OpenSource #Memory #HuggingFacehttps://huggingface.co/blog/funes7 Comments 0 Shares 6K Views 0 Reviews -
สร้าง Agent ขับเคลื่อนด้วยหน่วยความจำ ด้วย NVIDIA NeMo
ในยุคที่ปัญญาประดิษฐ์ (AI) ก้าวหน้าอย่างรวดเร็ว เราได้เห็นการพัฒนาของโมเดลภาษาขนาดใหญ่ (Large Language Models - LLMs) ที่มีความสามารถในการโต้ตอบและสร้างสรรค์ข้อความได้อย่างน่าทึ่ง อย่างไรก็ตาม LLMs แบบดั้งเดิมยังมีข้อจำกัดในการจดจำบริบทและการรักษาความต่อเนื่องของการสนทนาในระยะยาว
การมาถึงของ NVIDIA NeMo ซึ่งเป็นเฟรมเวิร์กที่ออกแบบมาเพื่อช่วยนักพัฒนาสร้างและปรับแต่ง LLMs ได้เปิดประตูสู่ความเป็นไปได้ใหม่ๆ หนึ่งในนั้นคือการสร้าง "Agent ขับเคลื่อนด้วยหน่วยความจำ" (Memory-Driven Agent) ที่สามารถจดจำข้อมูลจากการสนทนาที่ผ่านมา และนำมาใช้ในการตอบสนองได้อย่างชาญฉลาดและเป็นธรรมชาติมากขึ้น
Agent ขับเคลื่อนด้วยหน่วยความจำ คืออะไร?
Agent ประเภทนี้จะมีความสามารถในการ "จำ" ข้อมูลสำคัญที่เกิดขึ้นระหว่างการสนทนา ไม่ว่าจะเป็นข้อเท็จจริงที่ผู้ใช้ป้อนเข้ามา ความชอบส่วนบุคคล หรือแม้แต่ประวัติการสนทนาทั้งหมด จากนั้น Agent จะใช้ข้อมูลที่จำได้นี้มาประกอบการตัดสินใจและสร้างคำตอบที่เกี่ยวข้องและมีความต่อเนื่องกับบริบทเดิม
ลองนึกภาพว่าคุณกำลังคุยกับผู้ช่วย AI เกี่ยวกับการวางแผนท่องเที่ยว Agent ที่มีหน่วยความจำจะสามารถจดจำได้ว่าคุณเคยบอกว่าชอบทะเลสาบ และจะเสนอตัวเลือกสถานที่ท่องเที่ยวที่เป็นทะเลสาบให้โดยอัตโนมัติ โดยไม่ต้องให้คุณย้ำเตือนอีกครั้ง
ทำไมหน่วยความจำจึงสำคัญสำหรับ Agent?
- การสนทนาที่ต่อเนื่องและเป็นธรรมชาติ: การที่ Agent จำสิ่งที่คุยกันได้ ทำให้การสนทนาไหลลื่น ไม่ต้องเริ่มต้นใหม่ทุกครั้งที่ถาม
- การตอบสนองที่ตรงจุด: Agent สามารถอ้างอิงข้อมูลที่ได้รับมาก่อนหน้า ทำให้คำตอบมีความเฉพาะเจาะจงและมีประโยชน์มากขึ้น
- การสร้างความสัมพันธ์: การที่ Agent จำรายละเอียดเล็กๆ น้อยๆ ได้ ช่วยสร้างความรู้สึกผูกพันและความน่าเชื่อถือให้กับผู้ใช้
- การทำงานที่ซับซ้อน: Agent สามารถนำข้อมูลที่สะสมมาใช้ในการทำงานที่ต้องอาศัยการวางแผนและการตัดสินใจต่อเนื่อง เช่น การจัดการโปรเจกต์ หรือการให้คำแนะนำส่วนบุคคล
การสร้าง Agent ขับเคลื่อนด้วยหน่วยความจำด้วย NVIDIA NeMo
NVIDIA NeMo เป็นแพลตฟอร์มที่ทรงพลังซึ่งช่วยให้นักพัฒนาสามารถสร้าง LLMs ที่มีความสามารถขั้นสูงได้ การสร้าง Agent ที่มีหน่วยความจำนั้น อาศัยเทคนิคและการออกแบบที่ชาญฉลาด โดยทั่วไปแล้ว อาจเกี่ยวข้องกับ:
- การจัดการหน่วยความจำ (Memory Management): การออกแบบระบบที่สามารถจัดเก็บ ประมวลผล และเรียกใช้ข้อมูลที่จำเป็นจากประวัติการสนทนาได้อย่างมีประสิทธิภาพ
- การดึงข้อมูล (Information Retrieval): การพัฒนากลไกที่ช่วยให้ Agent สามารถค้นหาและดึงข้อมูลที่เกี่ยวข้องจากคลังหน่วยความจำได้อย่างรวดเร็ว
- การรวมบริบท (Context Integration): การนำข้อมูลจากหน่วยความจำมารวมกับข้อมูลใหม่ เพื่อสร้างคำตอบที่สมบูรณ์
NVIDIA NeMo นำเสนอเครื่องมือและ API ที่ช่วยอำนวยความสะดวกในกระบวนการเหล่านี้ ทำให้นักพัฒนาสามารถโฟกัสไปที่การออกแบบพฤติกรรมของ Agent และการสร้างประสบการณ์ผู้ใช้ที่ดีที่สุด
ประโยชน์ของการนำไปใช้
Agent ขับเคลื่อนด้วยหน่วยความจำสามารถนำไปประยุกต์ใช้ได้หลากหลายวงการ เช่น:
- ผู้ช่วยส่วนตัว: จดจำตารางนัดหมาย ความชอบ และให้คำแนะนำที่ปรับให้เหมาะกับแต่ละบุคคล
- บริการลูกค้า: จดจำประวัติการติดต่อ ปัญหาที่เคยแจ้ง และให้ความช่วยเหลือได้อย่างรวดเร็วและตรงจุด
- การศึกษา: สร้างสภาพแวดล้อมการเรียนรู้แบบโต้ตอบที่ปรับเนื้อหาตามความเข้าใจของผู้เรียน
- การพัฒนาเกม: สร้างตัวละคร AI ที่มีบุคลิกและความทรงจำของตัวเอง
สรุป
การพัฒนา Agent ขับเคลื่อนด้วยหน่วยความจำถือเป็นก้าวสำคัญในการทำให้ AI มีความสามารถใกล้เคียงมนุษย์มากขึ้น NVIDIA NeMo เป็นเครื่องมือสำคัญที่ช่วยให้นักพัฒนาสามารถสร้างสรรค์ Agent ที่ชาญฉลาดเหล่านี้ได้อย่างมีประสิทธิภาพ การมีหน่วยความจำจะช่วยยกระดับประสบการณ์การโต้ตอบกับ AI ให้ดียิ่งขึ้นในทุกมิติ
ขอบคุณ แหล่งข้อมูล
https://developer.nvidia.com/blog/building-a-memory-driven-agent-with-nvidia-nemoclaw/สร้าง Agent ขับเคลื่อนด้วยหน่วยความจำ ด้วย NVIDIA NeMoในยุคที่ปัญญาประดิษฐ์ (AI) ก้าวหน้าอย่างรวดเร็ว เราได้เห็นการพัฒนาของโมเดลภาษาขนาดใหญ่ (Large Language Models - LLMs) ที่มีความสามารถในการโต้ตอบและสร้างสรรค์ข้อความได้อย่างน่าทึ่ง อย่างไรก็ตาม LLMs แบบดั้งเดิมยังมีข้อจำกัดในการจดจำบริบทและการรักษาความต่อเนื่องของการสนทนาในระยะยาวการมาถึงของ NVIDIA NeMo ซึ่งเป็นเฟรมเวิร์กที่ออกแบบมาเพื่อช่วยนักพัฒนาสร้างและปรับแต่ง LLMs ได้เปิดประตูสู่ความเป็นไปได้ใหม่ๆ หนึ่งในนั้นคือการสร้าง "Agent ขับเคลื่อนด้วยหน่วยความจำ" (Memory-Driven Agent) ที่สามารถจดจำข้อมูลจากการสนทนาที่ผ่านมา และนำมาใช้ในการตอบสนองได้อย่างชาญฉลาดและเป็นธรรมชาติมากขึ้นAgent ขับเคลื่อนด้วยหน่วยความจำ คืออะไร?Agent ประเภทนี้จะมีความสามารถในการ "จำ" ข้อมูลสำคัญที่เกิดขึ้นระหว่างการสนทนา ไม่ว่าจะเป็นข้อเท็จจริงที่ผู้ใช้ป้อนเข้ามา ความชอบส่วนบุคคล หรือแม้แต่ประวัติการสนทนาทั้งหมด จากนั้น Agent จะใช้ข้อมูลที่จำได้นี้มาประกอบการตัดสินใจและสร้างคำตอบที่เกี่ยวข้องและมีความต่อเนื่องกับบริบทเดิมลองนึกภาพว่าคุณกำลังคุยกับผู้ช่วย AI เกี่ยวกับการวางแผนท่องเที่ยว Agent ที่มีหน่วยความจำจะสามารถจดจำได้ว่าคุณเคยบอกว่าชอบทะเลสาบ และจะเสนอตัวเลือกสถานที่ท่องเที่ยวที่เป็นทะเลสาบให้โดยอัตโนมัติ โดยไม่ต้องให้คุณย้ำเตือนอีกครั้งทำไมหน่วยความจำจึงสำคัญสำหรับ Agent?การสนทนาที่ต่อเนื่องและเป็นธรรมชาติ: การที่ Agent จำสิ่งที่คุยกันได้ ทำให้การสนทนาไหลลื่น ไม่ต้องเริ่มต้นใหม่ทุกครั้งที่ถามการตอบสนองที่ตรงจุด: Agent สามารถอ้างอิงข้อมูลที่ได้รับมาก่อนหน้า ทำให้คำตอบมีความเฉพาะเจาะจงและมีประโยชน์มากขึ้นการสร้างความสัมพันธ์: การที่ Agent จำรายละเอียดเล็กๆ น้อยๆ ได้ ช่วยสร้างความรู้สึกผูกพันและความน่าเชื่อถือให้กับผู้ใช้การทำงานที่ซับซ้อน: Agent สามารถนำข้อมูลที่สะสมมาใช้ในการทำงานที่ต้องอาศัยการวางแผนและการตัดสินใจต่อเนื่อง เช่น การจัดการโปรเจกต์ หรือการให้คำแนะนำส่วนบุคคลการสร้าง Agent ขับเคลื่อนด้วยหน่วยความจำด้วย NVIDIA NeMoNVIDIA NeMo เป็นแพลตฟอร์มที่ทรงพลังซึ่งช่วยให้นักพัฒนาสามารถสร้าง LLMs ที่มีความสามารถขั้นสูงได้ การสร้าง Agent ที่มีหน่วยความจำนั้น อาศัยเทคนิคและการออกแบบที่ชาญฉลาด โดยทั่วไปแล้ว อาจเกี่ยวข้องกับ:การจัดการหน่วยความจำ (Memory Management): การออกแบบระบบที่สามารถจัดเก็บ ประมวลผล และเรียกใช้ข้อมูลที่จำเป็นจากประวัติการสนทนาได้อย่างมีประสิทธิภาพการดึงข้อมูล (Information Retrieval): การพัฒนากลไกที่ช่วยให้ Agent สามารถค้นหาและดึงข้อมูลที่เกี่ยวข้องจากคลังหน่วยความจำได้อย่างรวดเร็วการรวมบริบท (Context Integration): การนำข้อมูลจากหน่วยความจำมารวมกับข้อมูลใหม่ เพื่อสร้างคำตอบที่สมบูรณ์NVIDIA NeMo นำเสนอเครื่องมือและ API ที่ช่วยอำนวยความสะดวกในกระบวนการเหล่านี้ ทำให้นักพัฒนาสามารถโฟกัสไปที่การออกแบบพฤติกรรมของ Agent และการสร้างประสบการณ์ผู้ใช้ที่ดีที่สุดประโยชน์ของการนำไปใช้Agent ขับเคลื่อนด้วยหน่วยความจำสามารถนำไปประยุกต์ใช้ได้หลากหลายวงการ เช่น:ผู้ช่วยส่วนตัว: จดจำตารางนัดหมาย ความชอบ และให้คำแนะนำที่ปรับให้เหมาะกับแต่ละบุคคลบริการลูกค้า: จดจำประวัติการติดต่อ ปัญหาที่เคยแจ้ง และให้ความช่วยเหลือได้อย่างรวดเร็วและตรงจุดการศึกษา: สร้างสภาพแวดล้อมการเรียนรู้แบบโต้ตอบที่ปรับเนื้อหาตามความเข้าใจของผู้เรียนการพัฒนาเกม: สร้างตัวละคร AI ที่มีบุคลิกและความทรงจำของตัวเองสรุปการพัฒนา Agent ขับเคลื่อนด้วยหน่วยความจำถือเป็นก้าวสำคัญในการทำให้ AI มีความสามารถใกล้เคียงมนุษย์มากขึ้น NVIDIA NeMo เป็นเครื่องมือสำคัญที่ช่วยให้นักพัฒนาสามารถสร้างสรรค์ Agent ที่ชาญฉลาดเหล่านี้ได้อย่างมีประสิทธิภาพ การมีหน่วยความจำจะช่วยยกระดับประสบการณ์การโต้ตอบกับ AI ให้ดียิ่งขึ้นในทุกมิติhttps://developer.nvidia.com/blog/building-a-memory-driven-agent-with-nvidia-nemoclaw/0 Comments 0 Shares 6K Views 0 Reviews


More Stories

 Arabic
 French
 Spanish
 Portuguese
 Deutsch
 Turkish
 Dutch
 Italiano
 Russian
 Romaian
 Portuguese (Brazil)
 Greek