
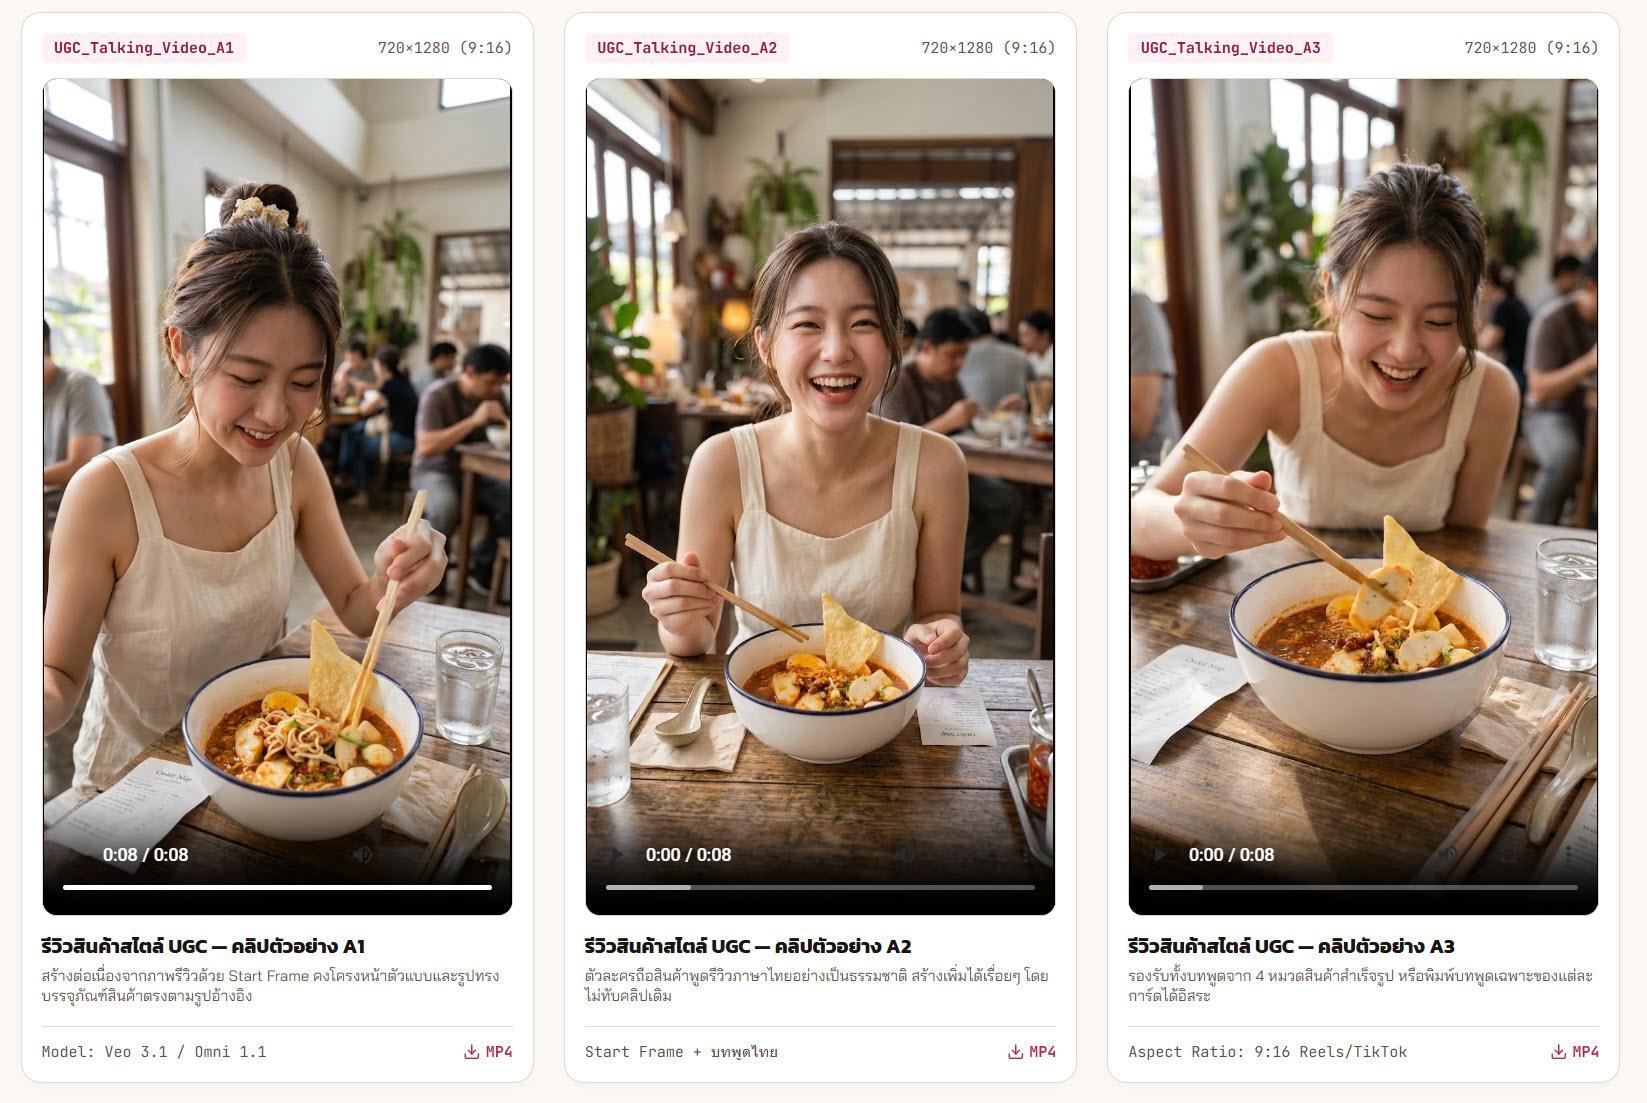
สร้างภาพรีวิวสินค้า 5 มุมมอง & คลิปพูดรีวิวไทยด้วย AI
เพียงอัปโหลดรูป คน/มาสคอต (Image 1 → WHO) และรูป สินค้า/อาหาร (Image 2 → WHAT) ระบบจะผสานทั้งสองเข้าด้วยกันเป็นภาพรีวิวที่ดูเป็นธรรมชาติเหมือนถ่ายด้วยมือถือ สินค้า 1 รูปได้ภาพผลลัพธ์ 5 แบบ (สูงสุด 50 ภาพต่อรอบ) พร้อมต่อยอดเป็น วิดีโอพูดรีวิวภาษาไทย ได้ทันที หรือสร้างตัวแบบ AI / มาสคอต 3D และภาพนำเสนอสินค้าใหม่ได้ในคลิกเดียว
เพียงอัปโหลดรูป คน/มาสคอต (Image 1 → WHO) และรูป สินค้า/อาหาร (Image 2 → WHAT) ระบบจะผสานทั้งสองเข้าด้วยกันเป็นภาพรีวิวที่ดูเป็นธรรมชาติเหมือนถ่ายด้วยมือถือ สินค้า 1 รูปได้ภาพผลลัพธ์ 5 แบบ (สูงสุด 50 ภาพต่อรอบ) พร้อมต่อยอดเป็น วิดีโอพูดรีวิวภาษาไทย ได้ทันที หรือสร้างตัวแบบ AI / มาสคอต 3D และภาพนำเสนอสินค้าใหม่ได้ในคลิกเดียว
-
1 persone piace questo elemento
-
6 Articoli
-
5 Foto
-
0 Video
-
Anteprima
-
LLM AI
Cerca

 English
 Arabic
 French
 Spanish
 Portuguese
 Deutsch
 Turkish
 Dutch
 Russian
 Romaian
 Portuguese (Brazil)
 Greek
Aggiornamenti recenti
-
สร้างภาพรีวิวสินค้า 5 มุมมอง & คลิปพูดรีวิวไทยด้วย AI
เพียงอัปโหลดรูป คน/มาสคอต (Image 1 → WHO) และรูป สินค้า/อาหาร (Image 2 → WHAT) ระบบจะผสานทั้งสองเข้าด้วยกันเป็นภาพรีวิวที่ดูเป็นธรรมชาติเหมือนถ่ายด้วยมือถือ สินค้า 1 รูปได้ภาพผลลัพธ์ 5 แบบ (สูงสุด 50 ภาพต่อรอบ) พร้อมต่อยอดเป็น วิดีโอพูดรีวิวภาษาไทย ได้ทันที หรือสร้างตัวแบบ AI / มาสคอต 3D และภาพนำเสนอสินค้าใหม่ได้ในคลิกเดียว
สร้างภาพรีวิวสินค้า 5 มุมมอง & คลิปพูดรีวิวไทยด้วย AIเพียงอัปโหลดรูป คน/มาสคอต (Image 1 → WHO) และรูป สินค้า/อาหาร (Image 2 → WHAT) ระบบจะผสานทั้งสองเข้าด้วยกันเป็นภาพรีวิวที่ดูเป็นธรรมชาติเหมือนถ่ายด้วยมือถือ สินค้า 1 รูปได้ภาพผลลัพธ์ 5 แบบ (สูงสุด 50 ภาพต่อรอบ) พร้อมต่อยอดเป็น วิดีโอพูดรีวิวภาษาไทย ได้ทันที หรือสร้างตัวแบบ AI / มาสคอต 3D และภาพนำเสนอสินค้าใหม่ได้ในคลิกเดียวhttps://ai-thai.com/_tools/0005-res/0 Commenti 0 condivisioni 382 Views 0 Anteprima -
สร้างและดาวน์โหลดคลิปวิดีโอพูดรีวิวไทย เพิ่มคลิปใหม่ได้เรื่อยๆ ไม่ทับของเดิม
• แสดงรหัสคลิป, บทพูดรีวิวไทยที่ใช้, ภาพเฟรมเริ่มต้น (Start Frame) และรูปอ้างอิง (Auto BG เมื่อไม่ได้ใส่สถานที่)
• ระบบคิวสร้างทีละ 1 คลิปต่อเนื่อง แสดงความยาวและโมเดลที่ใช้ (Veo 3.1 - Lite, Omni 1.1 Flash, Veo 3.1 - Fast)
• มีปุ่ม กดเล่นวิดีโอ (Play/Pause), สร้างใหม่, Download MP4 รายคลิป และปุ่ม Download All MP4 โหลดรวดเดียว
สร้างและดาวน์โหลดคลิปวิดีโอพูดรีวิวไทย เพิ่มคลิปใหม่ได้เรื่อยๆ ไม่ทับของเดิม• แสดงรหัสคลิป, บทพูดรีวิวไทยที่ใช้, ภาพเฟรมเริ่มต้น (Start Frame) และรูปอ้างอิง (Auto BG เมื่อไม่ได้ใส่สถานที่)• ระบบคิวสร้างทีละ 1 คลิปต่อเนื่อง แสดงความยาวและโมเดลที่ใช้ (Veo 3.1 - Lite, Omni 1.1 Flash, Veo 3.1 - Fast)• มีปุ่ม กดเล่นวิดีโอ (Play/Pause), สร้างใหม่, Download MP4 รายคลิป และปุ่ม Download All MP4 โหลดรวดเดียว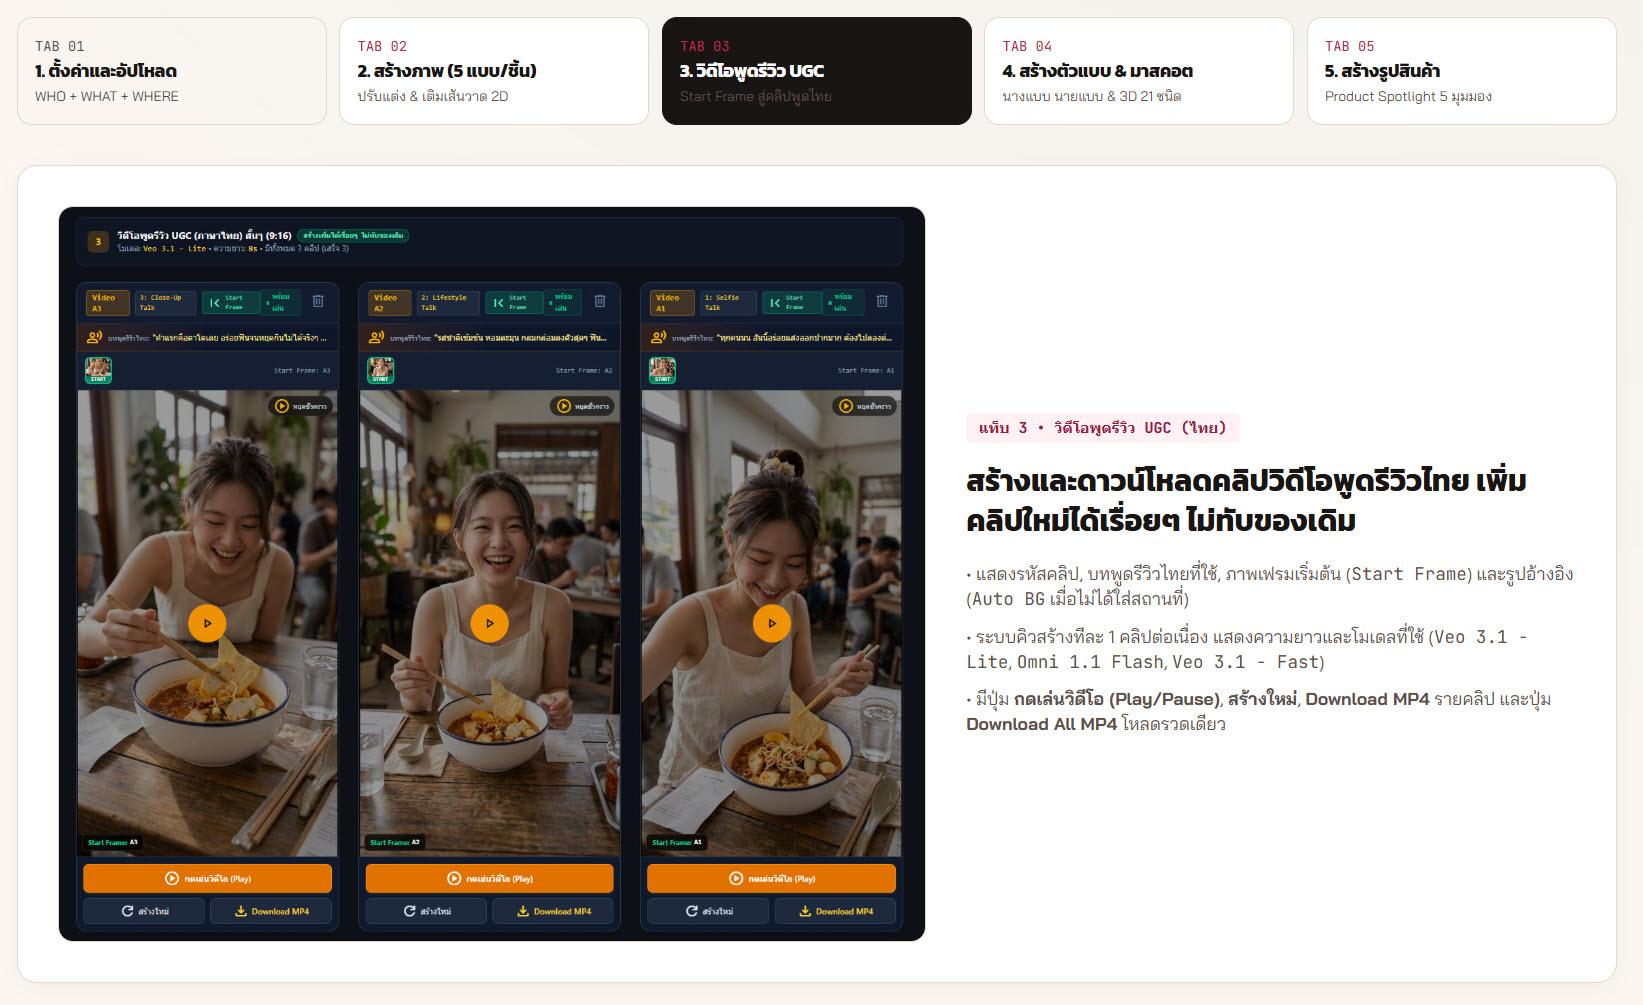 0 Commenti 0 condivisioni 382 Views 0 Anteprima
-
รับภาพรีวิว 5 มุมมอง (A1–A5) พร้อมปรับแต่งเฉพาะรูป & เติมเส้นวาดมือ 2D
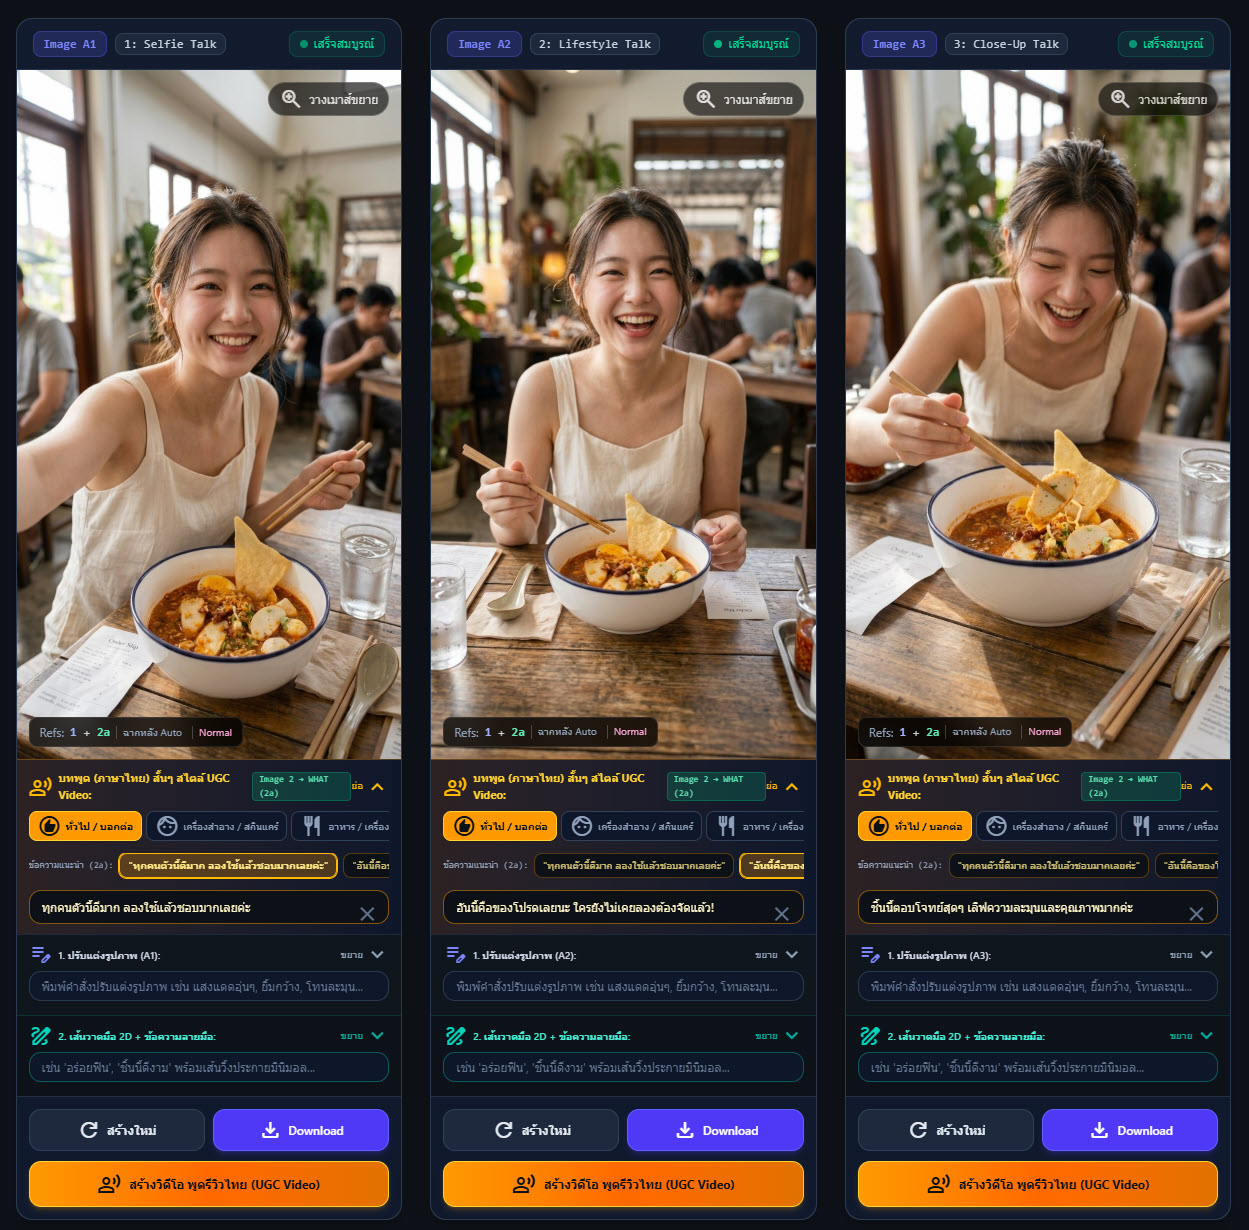
5 รูปแบบภาพที่ได้ต่อสินค้า 1 ชิ้น:
Selfie Talk — เซลฟี่สบตากล้อง รีวิวแบบเป็นกันเอง
Lifestyle Talk — ช่วงเวลาไลฟ์สไตล์เป็นธรรมชาติ
Close-Up Talk — โคลสอัปเจาะรายละเอียดสินค้าและมือ
ตัวละครจิ๋ว 2D — เติมตัวละครจิ๋ววาดมือเส้นหมึก 2D + ข้อความไทยลายมือน่ารัก
เส้นวาดมือ 2D — เติมเส้นวาดมือเส้นหมึก 2D + ข้อความไทยลายมือเป็นกันเอง
มาพร้อมระบบ Image Pool: 4 งานพร้อมกัน, ช่องพิมพ์คำสั่งแก้ไขภาพเฉพาะใบ, ช่องเพิ่มเส้นวาดมือ 2D + ข้อความลายมือ และปุ่มส่งภาพไปสร้างวิดีโอพูดรีวิวไทยได้ทันที
รับภาพรีวิว 5 มุมมอง (A1–A5) พร้อมปรับแต่งเฉพาะรูป & เติมเส้นวาดมือ 2D5 รูปแบบภาพที่ได้ต่อสินค้า 1 ชิ้น:Selfie Talk — เซลฟี่สบตากล้อง รีวิวแบบเป็นกันเองLifestyle Talk — ช่วงเวลาไลฟ์สไตล์เป็นธรรมชาติClose-Up Talk — โคลสอัปเจาะรายละเอียดสินค้าและมือตัวละครจิ๋ว 2D — เติมตัวละครจิ๋ววาดมือเส้นหมึก 2D + ข้อความไทยลายมือน่ารักเส้นวาดมือ 2D — เติมเส้นวาดมือเส้นหมึก 2D + ข้อความไทยลายมือเป็นกันเองมาพร้อมระบบ Image Pool: 4 งานพร้อมกัน, ช่องพิมพ์คำสั่งแก้ไขภาพเฉพาะใบ, ช่องเพิ่มเส้นวาดมือ 2D + ข้อความลายมือ และปุ่มส่งภาพไปสร้างวิดีโอพูดรีวิวไทยได้ทันที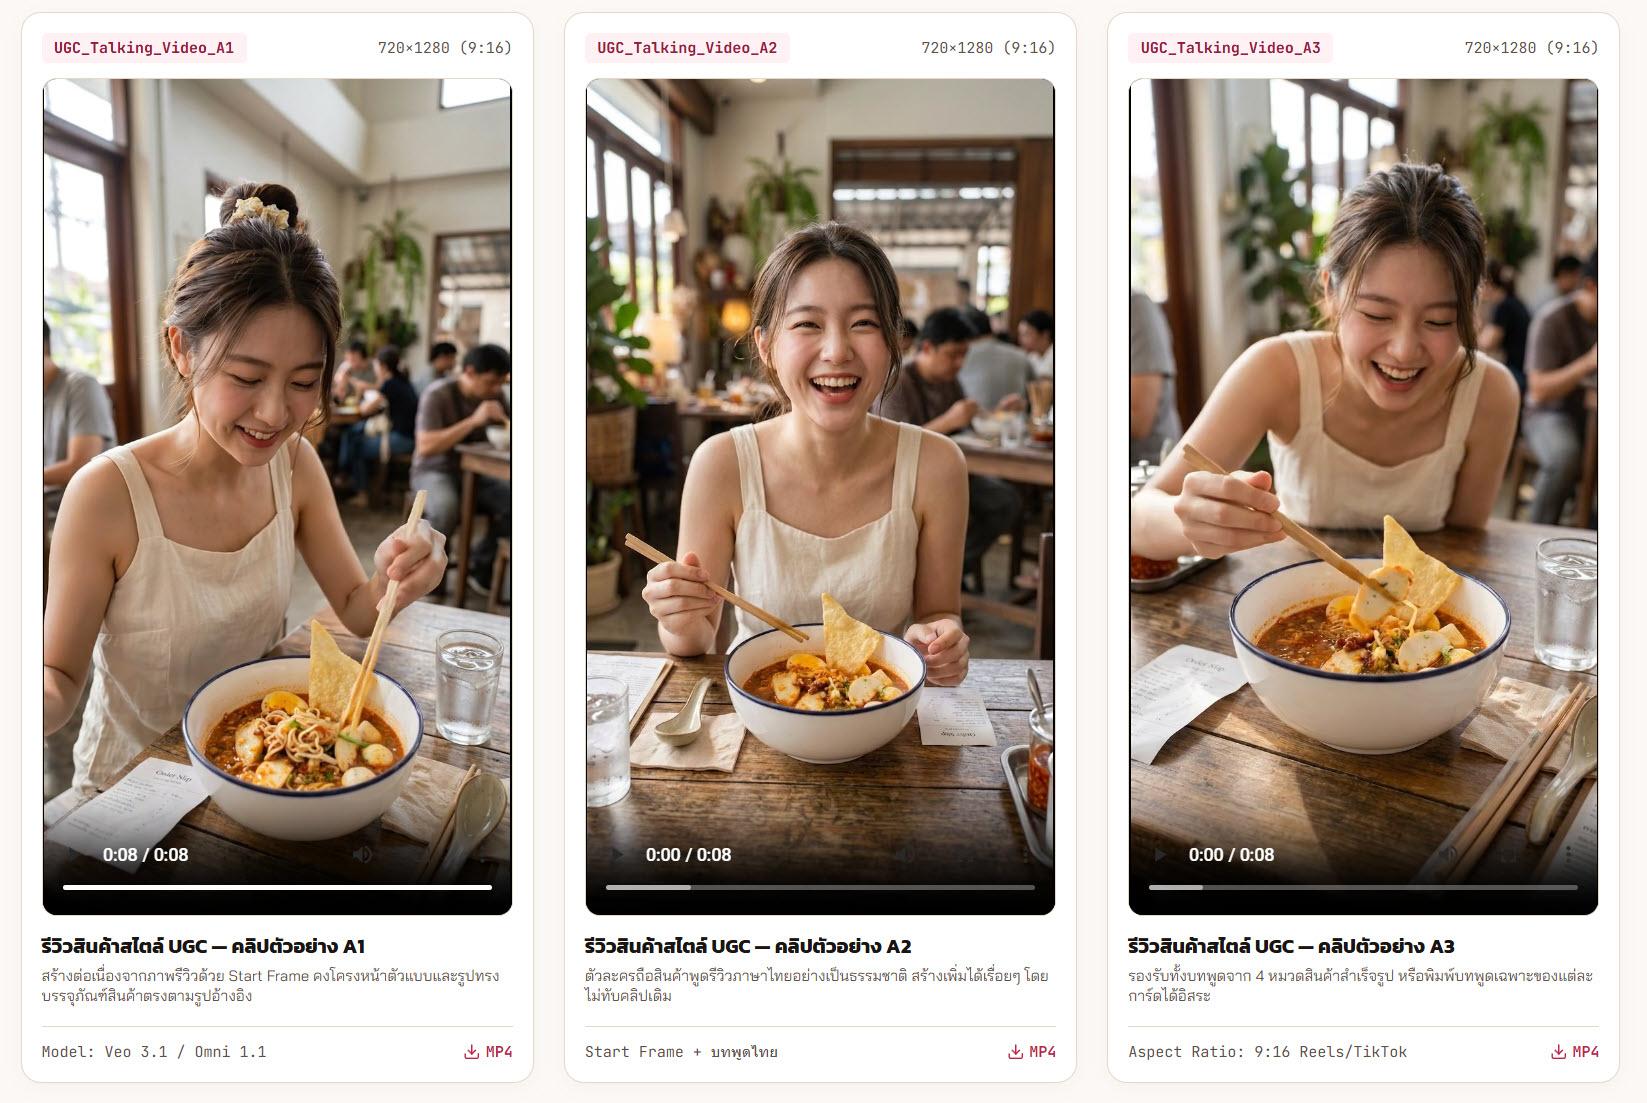 0 Commenti 0 condivisioni 382 Views 0 Anteprima
-
เตรียมรูปอ้างอิง 3 ช่อง (WHO / WHAT / WHERE) บทพูดไทย และตั้งค่าโมเดล
Image 1 → WHO:
(จำเป็น, 1 รูป) คน นางแบบ หรือมาสคอต รักษาโครงหน้า ผิว ทรงผม และเอกลักษณ์ตัวละคร
Image 2 → WHAT:
(จำเป็น, 1–10 รูป) สินค้าหรืออาหาร ติดป้าย 2a, 2b, ... อัตโนมัติ รักษารูปทรงและบรรจุภัณฑ์ตรงของจริง
Image 3 → WHERE:
(ไม่บังคับ, สูงสุด 5 รูป) สถานที่จริง หากไม่ใส่ระบบจะสร้างฉากหลังที่เข้ากันให้อัตโนมัติ
สูตรคำนวณ:
Image 2 (จำนวนรูป) × 5 = จำนวนชุดภาพ (สูงสุด 50 ภาพต่อรอบ)
เตรียมรูปอ้างอิง 3 ช่อง (WHO / WHAT / WHERE) บทพูดไทย และตั้งค่าโมเดลImage 1 → WHO:(จำเป็น, 1 รูป) คน นางแบบ หรือมาสคอต รักษาโครงหน้า ผิว ทรงผม และเอกลักษณ์ตัวละครImage 2 → WHAT:(จำเป็น, 1–10 รูป) สินค้าหรืออาหาร ติดป้าย 2a, 2b, ... อัตโนมัติ รักษารูปทรงและบรรจุภัณฑ์ตรงของจริงImage 3 → WHERE:(ไม่บังคับ, สูงสุด 5 รูป) สถานที่จริง หากไม่ใส่ระบบจะสร้างฉากหลังที่เข้ากันให้อัตโนมัติสูตรคำนวณ:Image 2 (จำนวนรูป) × 5 = จำนวนชุดภาพ (สูงสุด 50 ภาพต่อรอบ)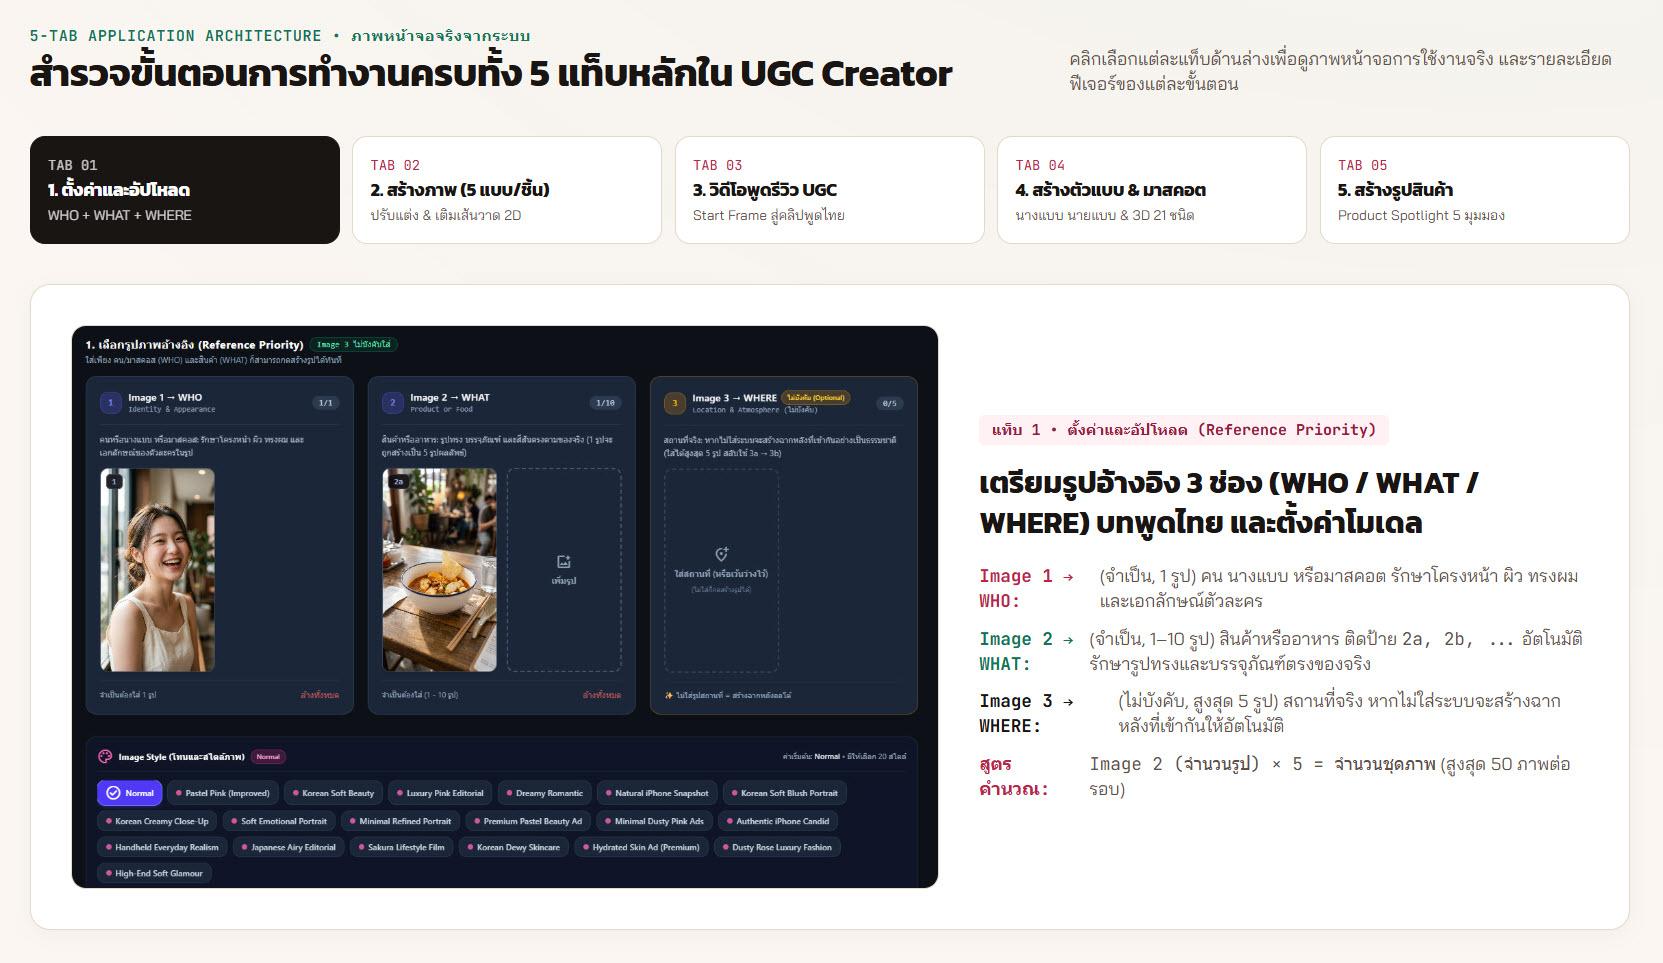 0 Commenti 0 condivisioni 382 Views 0 Anteprima
Altre storie